
不会写训练脚本,也能把 Kaggle 数据集跑成 YOLO 检测模型
一个把 Kaggle 数据集、YOLO 训练、推理和 Streamlit 界面串起来的模板,适合想做第一个目标检测实验的人。
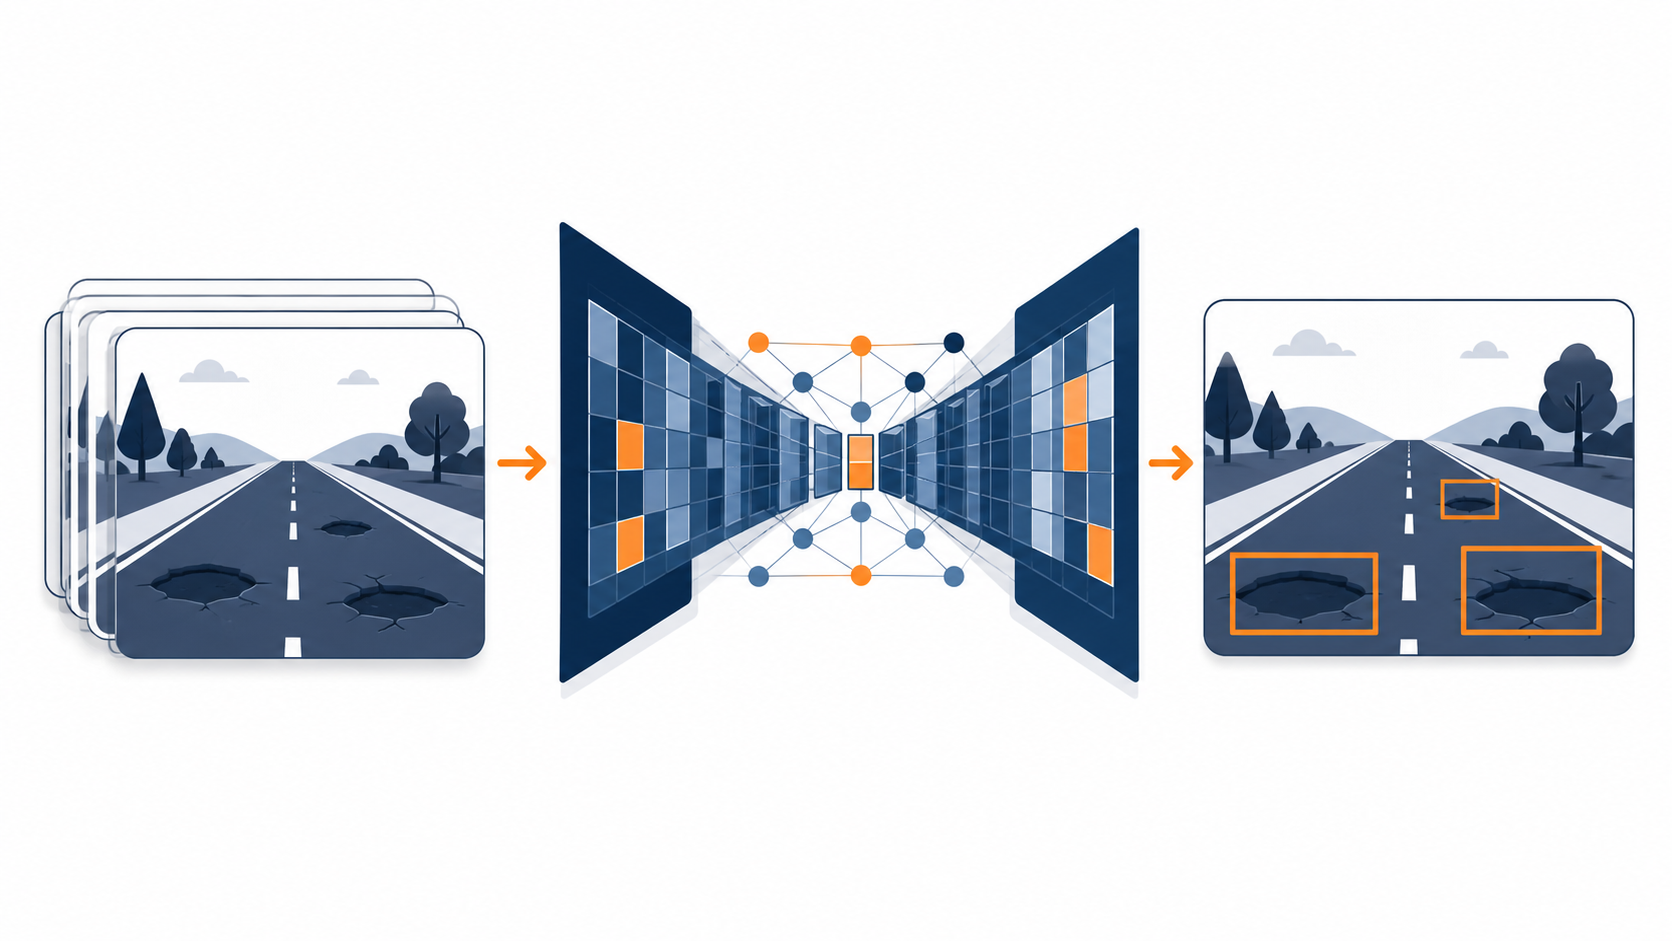
很多人第一次接触目标检测,卡在的不是模型原理,而是数据集、训练脚本、推理代码和运行环境同时要处理。
computer-vision-with-marco/yolo-training-template 把这条链路整理成了一个可以直接改参数的项目:从 Kaggle 下载数据集,训练 YOLO 模型,再对图片、视频或摄像头画面做检测。项目还提供 Notebook 、 Streamlit 网页界面和一份面向非开发者的 Colab 快速指南。
它能帮你完成什么
项目目前包含四块功能:
- 从 Kaggle 数据集下载目标检测数据,并自动识别常见的
train、valid、test目录。 - 调用 Ultralytics YOLO 训练模型,支持选择 YOLOv8 、 YOLO11 和 YOLO26 的不同尺寸模型。
- 对图片、视频和摄像头画面做推理,输出带检测框的结果。
- 清理和增强数据集,生成自动标注,并通过 Streamlit 页面完成训练、推理、预处理、数据集浏览和模型导出。
它还支持把训练后的模型导出为 NCNN 格式,方便后续尝试移动端或嵌入式部署。
项目当前 GitHub 默认分支是 main,仓库最近一次提交记录为 2026 年 5 月 5 日。 GitHub API 显示仓库在 2026 年 8 月 13 日有更新记录,当前没有正式 Release 。
最适合拿来做什么
这套模板适合三类人:
- 想用一个真实数据集跑通目标检测流程的初学者。
- 想快速验证“某个视觉问题能不能用 YOLO 解决”的开发者。
- 已经有数据集,但不想从训练、推理、预处理脚本开始搭项目的人。
项目自带的示例数据集列表里有坑洼检测等数据。你也可以换成自己的 Kaggle 数据集,只要数据能整理成 YOLO 常见的图片和标签目录结构。
跑通它,大致需要几步
最省事的方式是打开仓库里的 notebooks/yolo_template.ipynb,在 Google Colab 中运行。快速指南建议使用 GPU,并把训练结果和推理输出保存到 Google Drive 。
命令行方式则是先安装依赖:
pip install -r requirements.txt
训练时提供 Kaggle 数据集句柄、类别数量和类别名称:
python scripts/main.py \
  --dataset <kaggle-handle> \
  --nc <num-classes> \
  --names <class-names>
例如,一个只有“坑洼”这一类目标的数据集,需要把类别数量设为 1,再把类别名称写成 Potholes。训练脚本默认使用 yolov8m.pt,也可以通过参数切换模型、训练轮数、图片尺寸、批大小和设备。
训练完成后,对一张图片做检测:
python scripts/inference.py \
  --model runs/train/yolo_train/weights/best.pt \
  --input sample.jpg \
  --no-display
想用网页界面,可以运行:
streamlit run streamlit_app.py
它省掉了哪些重复工作
这个模板把几个常见的前置动作集中起来了:
- 自动下载 Kaggle 数据集。
- 根据目录结构生成 YOLO 所需的 YAML 配置。
- 在训练前选择清洗和数据增强。
- 用同一套推理脚本处理图片和视频。
- 在 Streamlit 页面里查看训练过程和部分数据集统计。
- 把训练好的权重导出为 NCNN 文件。
对刚开始做实验的人来说,价值主要在于先得到一个能跑的基线。你可以先确认数据、类别和模型流程都没有问题,再决定要不要继续改网络、调参或做部署。
也有几个边界要看清
第一,它不是一个开箱即用的识别产品。训练效果取决于数据量、标注质量、类别定义、训练参数和硬件。项目里的示例能检测坑洼,不代表换成你的数据集后也会得到同样效果。
第二,项目并没有替你解决数据授权和隐私问题。 Kaggle 数据集、自己采集的图片、摄像头画面,都要确认使用范围。做真实场景部署时,还要单独处理数据保存、访问权限和误检漏检。
第三,Streamlit 里的“上传数据集”训练路径目前还没有完全接通。代码中会提示上传数据集训练尚未完整集成,实际使用时应优先走 Kaggle 数据集流程,或者直接调整脚本。
第四,仓库根目录当前没有 LICENSE 文件,GitHub API 的 license 字段也是空值。你可以阅读和运行公开代码,但如果准备把它放进商业项目,先联系维护者确认授权方式,不要自行假定它属于某一种开源许可证。
第五,依赖项比较重,包含 Ultralytics 、 OpenCV 、 Albumentations 、 Streamlit 、 GroundingDINO 等组件。普通电脑可以做小规模实验,但训练速度和显存占用会随模型大小、图片尺寸和批大小明显变化。
谁值得试一下
如果你手里已经有一份格式比较规整的目标检测数据集,这个模板可以帮你很快完成第一次训练和推理。你会得到一套可以继续改造的目录结构,也能看到从数据到模型输出的完整过程。
如果你的目标只是识别几类固定物体,也可以先用现成的视觉服务或标注平台做验证。等你确认数据和需求都值得投入,再把训练流程迁到自己的环境里。
项目地址:
https://github.com/computer-vision-with-marco/yolo-training-template
对大多数初学者来说,先跑通一个小数据集,比一开始研究几十个训练参数更有用。模型能不能继续用,等第一轮结果出来再判断。