
AI 也能看懂业务数据?WrenAI把自然语言接到可治理的 BI
WrenAI 把数据库结构、业务口径和 AI Agent 放到同一条链路里,让自然语言问题可以落成 SQL、图表和可分享的仪表盘。但它解决的是上下文和治理,不是替你承担数据责任。
很多公司已经有数据库、报表工具和 AI 助手,问题却仍然没有变:你问“上季度华东客户的续费率”,AI 可能能写出一条看起来很像样的 SQL,却不知道“客户”“续费”和“华东”在这家公司到底怎么定义。
WrenAI 想处理的,正是这层业务语义。它不是单纯的 Text-to-SQL 接口,而是一个面向 AI Agent 的开源 GenBI 引擎:让 Agent 生成 SQL 和图表,再把结果整理成可以分享的仪表盘。
WrenAI 到底是什么
可以把它理解成数据库和 AI Agent 之间的“业务上下文层”。除了表、字段和关系,它还可以承载指标定义、枚举值、批准过的查询、访问规则,以及写在文档、 Wiki 和聊天记录里的业务知识。
它的工作链路大致是:
- 你用自然语言提出问题;
- WrenAI 从语义模型和业务上下文里找出相关信息;
- Agent 生成经过约束的 SQL,并执行查询;
- 结果继续生成图表或仪表盘;
- 仪表盘可以部署到自己的 Vercel 或 Cloudflare Pages 账号。
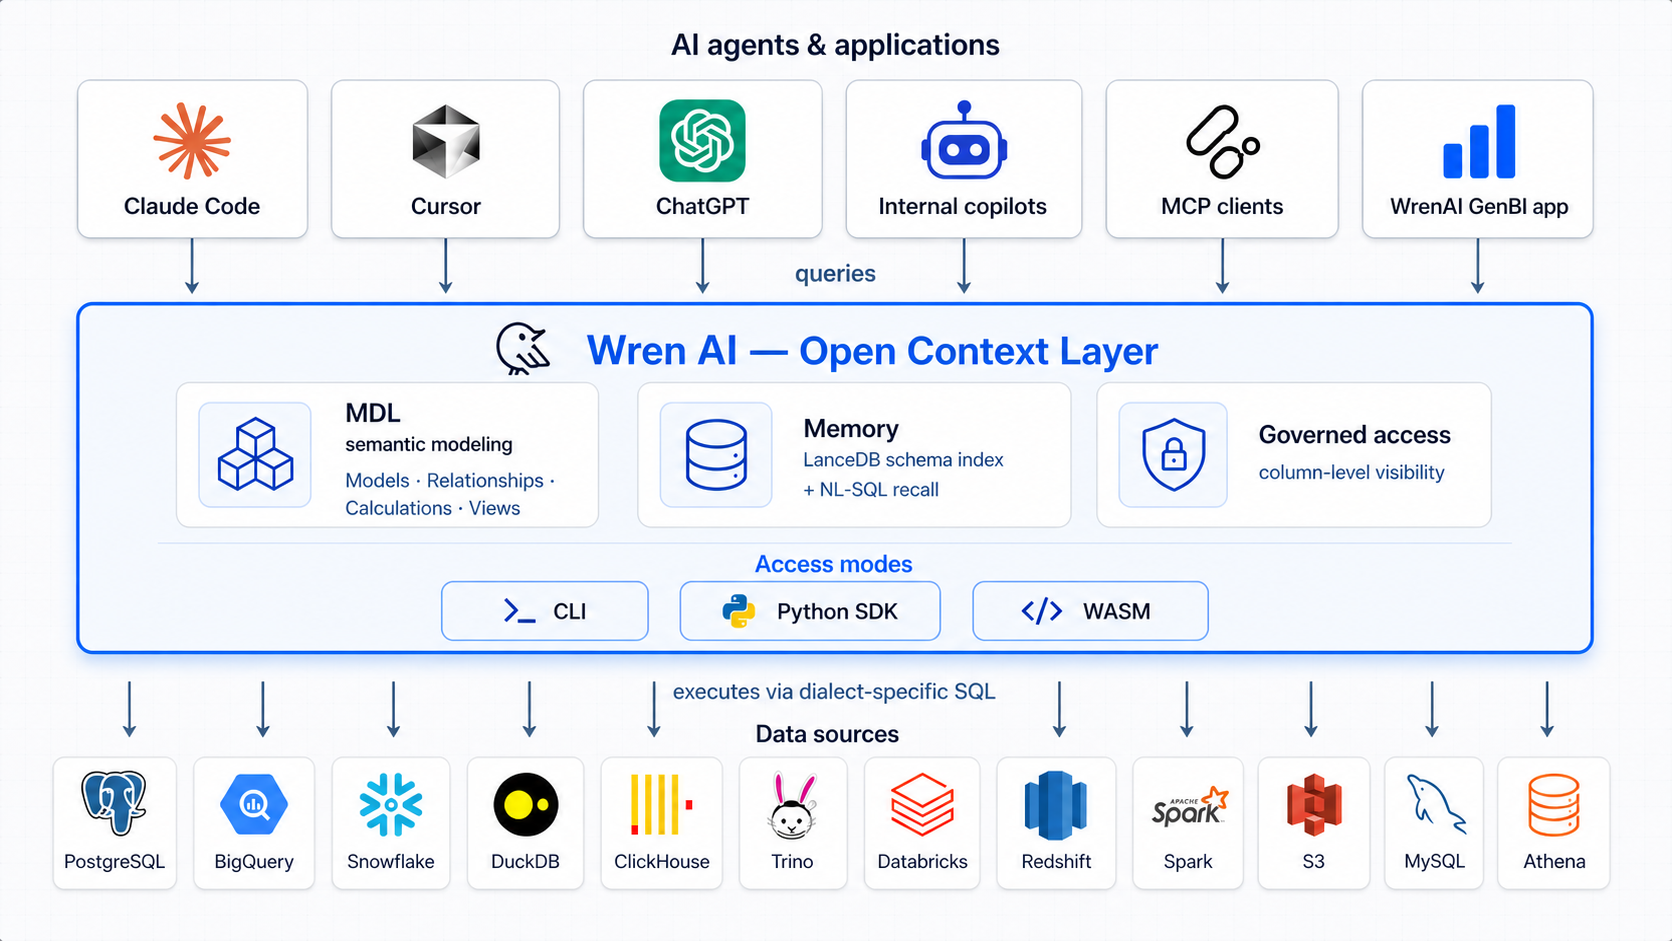
这张架构图里,上面是 Claude Code 、 Cursor 、 ChatGPT 、内部 Copilot 、 MCP 客户端等 AI 入口,中间是 Wren 的开放上下文层,下面接 PostgreSQL 、 BigQuery 、 Snowflake 、 DuckDB 、 ClickHouse 、 Databricks 、 Redshift 、 MySQL 等数据源。
它能做什么
1. 给 SQL 加上业务口径
WrenAI 的 MDL,也就是 Modeling Definition Language,可以描述模型、字段、关系、计算和视图。业务规则不再只藏在某个人的提示词里,而是变成项目文件,可以审阅、版本管理和复用。
这很重要。因为“销售额”到底是否包含退款,“活跃用户”按登录还是按付费,往往不是数据库字段名能说明白的。
2. 让不同 Agent 共用一套上下文
仓库提供 CLI 、 Python SDK 和 WASM 等访问方式,也提供面向 Agent 工作流的技能和 SDK 。你可以让 Claude Code 、 Cursor 、 MCP 客户端或内部 Copilot 使用同一套业务定义,而不是每个工具单独维护一份提示词。
3. 从答案继续做成仪表盘
WrenAI 当前的 GenBI 路线不止返回一段 SQL 。 Agent 可以把查询结果变成浏览器端仪表盘,再部署到自己的托管账号。这对临时分析、内部经营看板和面向团队的分享更实用。
4. 处理多种数据源
项目 README 当前写的是 22+ 数据源,仓库描述中列举了 BigQuery 、 Snowflake 、 PostgreSQL 、 ClickHouse 、 Amazon Redshift 、 Databricks 等。具体能否接入,还要看对应连接器、驱动、权限和当前版本,不要把“支持”理解成所有数据库都能无配置即用。
最小上手路径
WrenAI 现在是 Agent-driven,也就是让 AI Agent 帮你完成初始化,而不是先打开一个大而全的 BI 管理后台。
先安装 CLI:
pip install wrenai
如果需要特定数据源或记忆能力,再按项目说明安装额外依赖,例如:
pip install "wrenai[postgres,memory]"
接着给所用的 AI 客户端安装 WrenAI 的 discovery stub:
npx skills add Canner/WrenAI
然后在项目目录里直接告诉 Agent:
使用 Wren 设置我的 Postgres 数据库,并跑出第一条查询。
Agent 会读取 onboarding 流程,检查环境、创建连接配置、生成项目文件,并尝试跑第一条查询。后续可以继续让它补充业务上下文,或者把查询结果做成可分享的仪表盘。
如果你只是想先试试,不想接自己的数据库,仓库还提供了 jaffle_shop 示例数据集,可以用来走通从建模到查询的完整链路。
它不能替你解决什么
这里需要把宣传话术和工程现实分开。
第一,WrenAI 不会自动知道公司的真实业务口径。你没有维护 MDL 、说明文件和经过确认的示例查询,系统仍然可能基于错误上下文生成错误 SQL 。
第二,“有治理”不等于“不会出错”。仓库提供了 schema 检索、 dry-plan 、结构化错误、行数限制、访问控制和评估工具,但查询结果仍然需要业务人员抽查。尤其是财务、薪酬、客户和合规数据,不能因为 SQL 能执行就直接当成结论。
第三,私有化不等于没有成本。你仍然要负责数据库权限、凭据管理、模型调用、数据脱敏、审计、部署和升级。 AI Agent 能帮你操作流程,不能替你承担这些责任。
第四,仓库的产品路线已经发生过变化。当前主分支把 Wren Engine 合并到了 core/,过去基于 Docker 的聊天式 GenBI 产品保留在 legacy/v1,名称是 Wren GenBI Classic;README 明确写着这个旧分支不再提供新功能和安全修复。准备部署前,要确认自己跟的是当前主线还是旧产品路线。
适合谁
WrenAI 更适合三类人:
- 已经有数据仓库,但 AI Agent 经常误解字段和指标的团队;
- 想把业务定义、查询示例和访问规则放进 Git 管理的工程团队;
- 希望让多个 AI 客户端共用一套数据上下文,并进一步生成内部仪表盘的人。
如果你只是想从一个 CSV 画一张图,或者只需要一次性的 SQL,WrenAI 可能太重。它的价值建立在持续维护业务上下文上,接入的数据和团队越复杂,这层上下文越值得投入。
许可和来源
WrenAI 不是简单的“整个仓库统一一个许可证”。根目录的 LICENSE 说明:core/、sdk/、skills/、examples/ 和大多数根目录文件采用 Apache License 2.0;docs/ 采用 CC BY 4.0 。具体发布包还要以各自的 Cargo.toml、pyproject.toml 或 package.json 为准。 Wren 、 WrenAI 名称和项目 Logo 属于商标,使用规则另行处理。
一句话判断:WrenAI 的重点不是让 AI “猜得更准”,而是把业务定义、查询过程和访问边界变成一套可以审阅的上下文。它能让自然语言分析更接近真实业务,但前提是有人愿意把业务规则写清楚,并且继续检查结果。
来源链接: