
本地变声工作台 VoxWeave:声音处理留在自己电脑里
VoxWeave 是本地 RVC 变声工作台:可转音频、歌曲、视频和实时麦克风。当前只在 Windows 11 + NVIDIA 显卡上验收通过,不含现成声音模型。
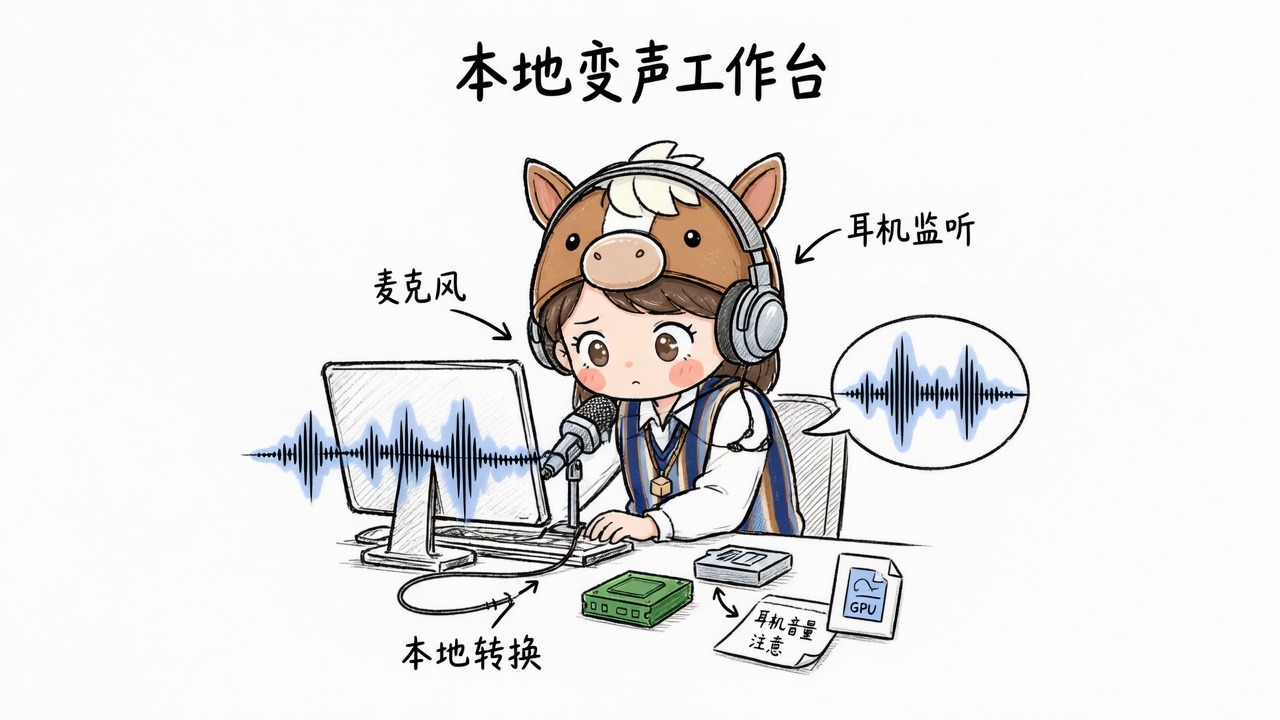
想改旁白、游戏语音或短视频人声,很多人第一反应是找在线变声网站。方便是方便,声音文件会先离开你的电脑。
VoxWeave 走另一条路:把 RVC 变声做成本机工作台。桌面端、命令行和本机接口共用同一个后台服务,转换任务和实时会话都在你选中的数据目录里完成。当前开源版本是 0.1.0,源码许可证 AGPL-3.0-only。
先把结论摊开:它是什么、能做什么、不能做什么、适合谁,风险在哪。安装只写最短路径。
它是什么
VoxWeave 是本地优先的 RVC(Retrieval-based Voice Conversion,基于检索的语音转换)工作台。你可以把它理解成:电脑上的“变声加工台”,而不是把录音上传到某家云服务再下载结果。
0.1 版本把这些能力装在同一套服务里:
- 离线转换:音频、歌曲、视频;
- 实时麦克风变声;
- 批量目录、持续监控目录;
- 人声/伴奏分离、 VAD(语音活动检测)、多说话人聚类、指定说话人转换;
- 最多四组参数试听;
- 最终产物和实时会话会记录所用模型与索引的哈希,方便以后核对“当时到底用了哪份权重”。
它管转换、任务、设备和结果落盘。声音模型从哪来、怎么训练,都不归它。
能做什么
按仓库 README 和 0.1 验收说明,能力大致是这些:
-
本地文件变声
把一段语音、旁白或对白,按你导入的 RVC 模型换成目标音色。 -
歌曲处理
可做人声与伴奏分离,再只转换主唱并混回伴奏。分离模型默认不自动下载;只有你确认来源和许可后,才可显式安装。 -
视频处理
验收记录里写过:成片可保留原视频流和原音轨,再附加一条变声后的音轨,而不是无脑重编码整条片子。长视频会按块处理。 -
实时麦克风
在 Windows 上选择本机输入/输出设备,边说边变。默认约 0.5 秒音频块;机器吃力时可切到 1.0 秒稳定档,用更高延迟换连续感。连续模式建议戴耳机,输入和输出必须属于同一个音频接口。 -
批量与监控
可对目录做批量任务,也可持续监控新文件入队。 -
给自动化/脚本用
同一后台提供本机 HTTP/WebSocket 和 CLI 。长任务会返回task_id,适合自己写小工具对接,不适合指望“装完就有云端账号体系”。
不能做什么
README 把边界写得很死:
- 不包含声音模型。仓库不随包装现成“某明星/某角色”模型;官方目录目前也是空的、可审计的。模型要你自己合法导入。
- 不做模型训练。想炼自己的音色,得去 RVC 训练流程,不在 VoxWeave 0.1 范围。
- 不做 GPT-SoVITS,也不提供虚拟声卡。
- 不是一键安装包。现阶段不生成安装器、压缩包或整合运行时;从源码启动。
- 真机验收平台目前只有 Windows 11 + NVIDIA CUDA。源码里保留了 Linux 、 macOS 的运行边界,但后两个平台还没有真机验收,不能当成“三端都能稳跑”。
- 不会自动清理中间文件。磁盘变满时,要你在设置里确认归档,或显式提交归档任务。
只想手机上点两下换搞笑音色,会觉得这项目太重。它面向愿意在 Windows 上搭环境的人。
适合谁,不适合谁
更合适:
- 有一台带 NVIDIA 显卡的 Windows 11 电脑;
- 愿意装 Python 3.12 、 Git 、 FFmpeg,并按脚本初始化环境;
- 做播客后期、本地视频配音、游戏语音、内部演示,并且希望素材尽量留在本机;
- 能自己管理 RVC 模型文件,也接受“模型授权归使用者自己负责”。
不太合适:
- 只有手机,或只有核显/AMD 且不想折腾 CUDA 环境;
- 期望双击一个安装包、内置很多现成明星声线;
- 需要官方承诺 Linux/macOS 生产可用;
- 想用来未经同意地模仿真人声音去骗人、冒充客服、做欺诈内容。
你需要准备什么
按 README 的最短要求:
| 项目 | 说明 |
|---|---|
| 系统 | 当前验收:Windows 11 |
| 显卡 | NVIDIA,CUDA 可用 |
| 软件 | Python 3.12 、 Git 、 FFmpeg |
| 数据目录 | 建议放在源码目录之外,例如 D:\Tools\VoxWeave |
| RVC 环境 | 可指向已有 Retrieval-based-Voice-Conversion-WebUI;也可在启动后让服务在数据目录内安装锁定版本 |
| 模型 | 自行准备有权使用的 RVC .pth 与对应 index |
首次配置时,用仓库里的 scripts\bootstrap.ps1 指定数据目录、 RVC 路径和 FFmpeg 路径;之后 scripts\run.ps1 或双击根目录 VoxWeave.bat 启动桌面端。没有现成 RVC 时,可在环境就绪后执行 runtime.install,让后台在数据目录安装锁定的 RVC 源码与推理资源。
人声分离模型默认不下载,因为当前指定模型缺少可确认的再分发许可证;WeSpeaker ONNX(说话人相关)使用 CC-BY-4.0,默认会装。
上手路径(只保留关键几步)
- 从 GitHub 仓库
CheshireMew/VoxWeave获取 0.1 源码。 - 准备 Python 3.12 、 Git 、 FFmpeg 和 NVIDIA 驱动/CUDA 环境。
- 运行
bootstrap.ps1,把数据和虚拟环境放到源码外的数据目录。 run.ps1或VoxWeave.bat打开桌面端。- 导入你有权使用的 RVC 模型,先拿一小段自己的录音试听参数。
- 再处理完整音频、歌曲或视频;实时模式先开测试模式,确认电平和延迟。
完整命令和协议见仓库 README.md、docs/PROTOCOL.md、docs/ARCHITECTURE.md、docs/VALIDATION.md。 0.1 还早,这里不写成“复制粘贴必成”的操作手册。
风险和规矩
-
声音授权
模型文件可能模仿真实人物或角色。使用者必须取得声音主体、模型制作方和素材权利人的必要许可,并遵守当地法律与平台规则。开源软件许可证,不等于某个人把声音使用权送给你了。 -
许可证
VoxWeave 源码是 AGPL-3.0-only。若你改代码并以网络服务形式提供给他人使用,AGPL 对源码公开有更严要求,二次分发前先读LICENSE和THIRD_PARTY_NOTICES.md。 -
模型政策
官方目录只接受来源可追溯、许可明确、带 SPDX 与 SHA-256 的条目。许可不明或禁止再分发的模型不能进官方目录;你仍可本机导入,但记录会标成未知或用户自报许可,且不会自动上传。 -
硬件与稳定性
实时会话会独占 GPU:已有离线任务时不能开实时;实时进行中新任务会排队。机器性能不够时,延迟和断续都会上来。 -
隐私
默认路径是本机处理。你自己若把结果上传到公网、或把本机 API 暴露到公网,风险就回到你的网络配置上。发现文件含本机回环端口和临时令牌,不要把这些文件当普通截图乱发。 -
项目阶段
0.1.0 很新(2026-08 前后发布),功能还在快速迭代。用它处理重要成片前,先用小样验证音质、延迟和成片封装。
小结
VoxWeave 适合这批人:有 Windows + NVIDIA,想在本地做 RVC 变声,并能自己管理模型和授权。
它不适合指望“打开网页就换声”、也不适合把未授权的真人声线当玩具公开传播。
仓库地址:
https://github.com/CheshireMew/VoxWeave
用之前先读 README 、 MODEL_POLICY.md 和 LICENSE 。模型从哪来、声音能不能用,责任在操作的人。