
喜欢薅羊毛的人有福了:OmniRoute把90+免费 AI 额度接到一个入口
OmniRoute 是一个本地 AI 网关,把多个模型提供商、免费额度和自动降级策略接到一个 OpenAI 兼容入口。它能省下不少重复配置,但免费额度会变化,服务条款和数据安全仍要自己负责。
喜欢薅免费额度的人,最烦的不是没有羊毛,而是羊毛太分散:这个平台给一点,那个平台给一点;每家接口格式不一样,限额也不一样,今天能用的模型,明天可能就换规则。
OmniRoute 想做的事情很直接:在本机跑一个 AI 网关,把多个模型提供商接到一个 OpenAI 兼容入口,再根据额度、价格、延迟和失败情况自动选择后端。
这样一来,Claude Code 、 Codex 、 Cursor 、 Cline 等工具不必分别配置一堆地址和密钥。你只需要把它们指向本机的一个入口,后面的模型由 OmniRoute 负责路由。
OmniRoute 是什么
OmniRoute 是一个 MIT 许可的开源 AI 网关,项目用 TypeScript 编写,当前 README 宣称接入 290 个提供商、 500+ 模型,其中包含 90+ 个免费方案。
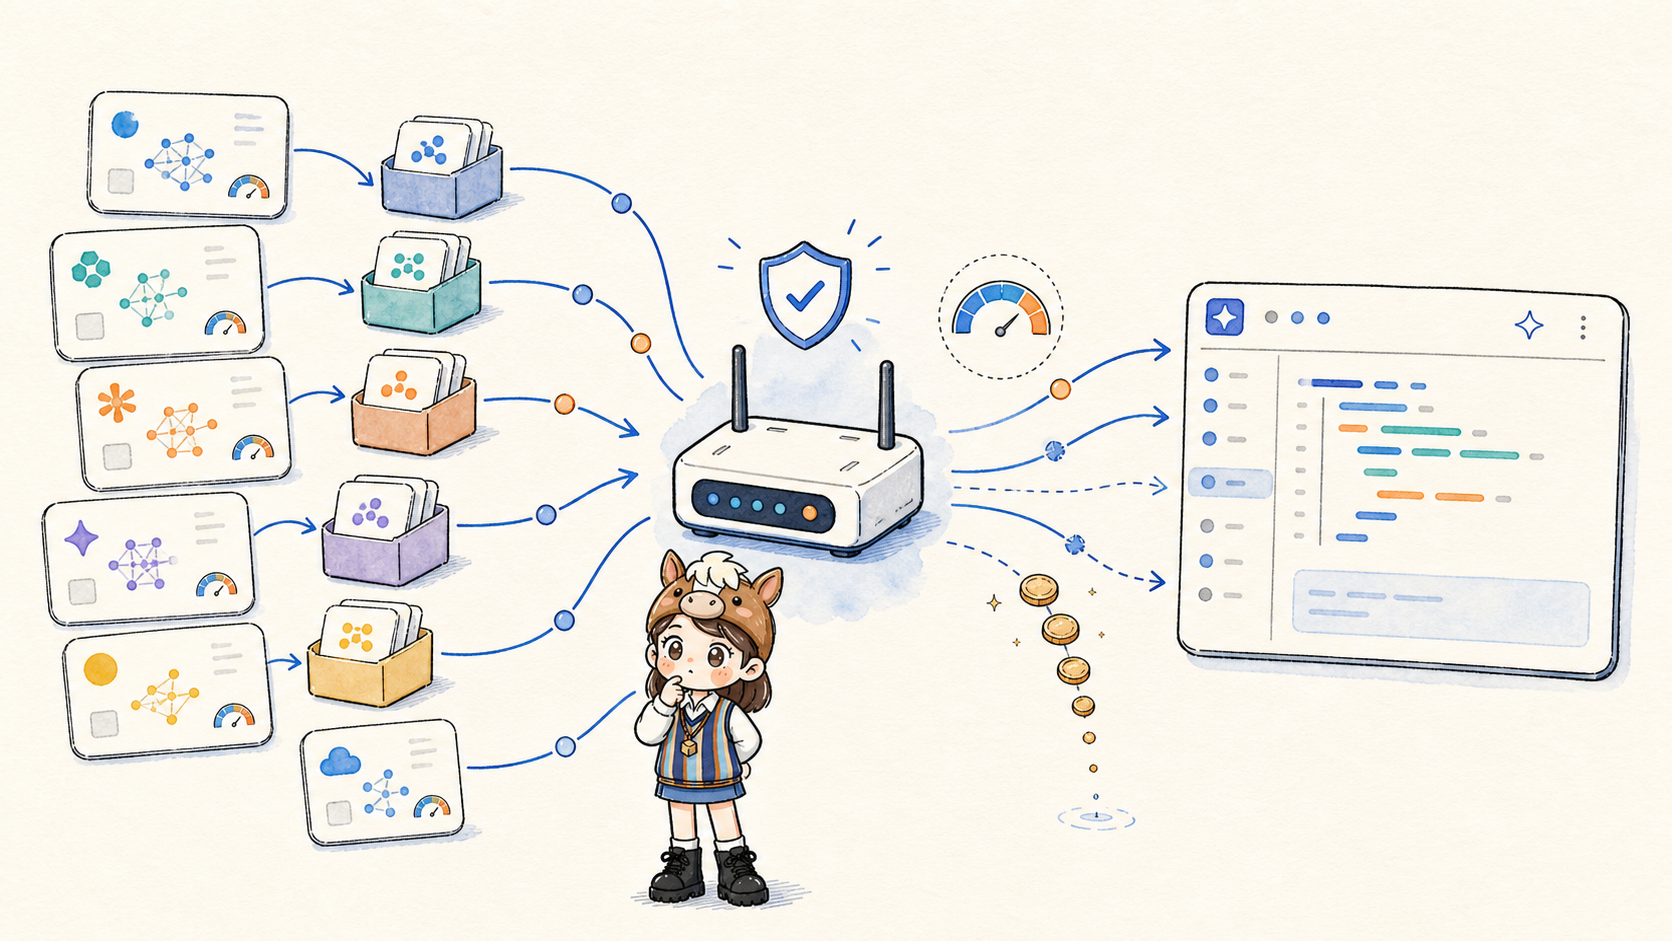
它的核心不是某一个模型,而是中间这一层:
- 对上,提供一个统一的 OpenAI 兼容接口;
- 中间,按策略选择模型、压缩上下文、处理失败和限流;
- 对下,连接订阅型模型、 API Key 模型、低价模型和免费模型。
项目 README 还提供了一个“免费额度预算”页面,用来汇总公开记录的免费层级。当前页面写的是约 1.53B tokens/月,计算来自 43 个 provider pool 、 516 个模型,并且会定期重新审计。
这里的关键词是“公开记录”和“重新计算”。这不是一张永久有效的免费额度承诺。
它能帮你做什么
1. 一个入口接多个模型
安装后,工具可以统一调用:
http://localhost:20128/v1
对于支持 OpenAI 兼容接口的客户端,这意味着配置一次,就可以切换不同提供商。需要用 Claude 、 GPT 、 Gemini 、 DeepSeek 、 GLM 或其他模型时,不必每次都重写整套配置。
项目还提供了 CLI 、 Dashboard 、 MCP 、 A2A 和 OpenCode 插件等入口,适合想把模型路由放进日常开发工具的人。
2. 自动降级,不把额度浪费在单点上
OmniRoute 把后端分成不同层级,可以优先使用订阅、 API Key 或低价模型,额度耗尽后再切换到其他候选项。也可以按照质量、速度、价格、剩余额度等目标设置 auto、auto/coding、auto/fast 和 auto/cheap 等模式。
这解决的是“一个接口挂了,整套工作流跟着停”的问题。它不保证每次切换都能得到完全相同的输出质量,尤其是不同模型的上下文长度、工具调用能力和代码水平可能差别很大。
3. 压缩上下文,少花一些 token
项目包含 RTK 和 Caveman 等压缩能力,README 宣称可以节省 15% 到 95% 的 tokens,平均值约 89% 。这个数字来自项目自己的说明,实际效果取决于任务类型、工具输出和压缩策略。
对 Coding Agent 来说,最容易膨胀的是终端输出、重复日志、长文件和工具调用结果。压缩的目标不是把所有内容都删掉,而是减少不影响下一步判断的冗余。
使用时仍然要保留原始输出恢复和校验路径,不能为了省 token 把关键错误、参数或代码片段压没了。
4. 把免费额度集中管理
对于愿意自己注册多个服务、比较不同免费层级的人,OmniRoute 的 Dashboard 可以把提供商、模型、使用量和剩余额度放在一起看。
项目 README 当前列出的免费层级包括长期免费、每日免费、注册赠送额度和限时活动额度。不同类型的额度不能混为一谈:注册赠送额度可能只有一次,免费层级可能随政策变化,某些提供商还会标注服务条款风险。
最小上手路径
如果只是体验,项目 README 给出的路径很短:
npm install -g omniroute
omniroute
默认服务会运行在本机 20128 端口。启动后,可以把支持 OpenAI 兼容协议的工具指向:
http://localhost:20128/v1
项目 README 还展示了一个无需预先填入凭据的 auto 示例:
curl http://localhost:20128/v1/chat/completions \\
  -H "Content-Type: application/json" \\
  -d '{"model":"auto","messages":[{"role":"user","content":"Hello!"}]}'
不过,“不需要 API Key”只适用于项目已经接好的特定免费后端和当前可用状态,不代表所有 290 个提供商都可以匿名使用。需要付费模型、自己的订阅或自定义提供商时,仍然要在本地配置相应凭据。
如果想用 Docker,README 也提供了本地绑定端口和数据卷的方式:
docker run -d --name omniroute --restart unless-stopped \\
  -p 127.0.0.1:20128:20128 \\
  -v omniroute-data:/app/data \\
  diegosouzapw/omniroute:latest
初次部署建议先绑定到 127.0.0.1,不要直接把没有完成鉴权和 HTTPS 配置的管理面板暴露到公网。
它不能替你解决什么
免费额度不是固定资产
项目自己的免费额度文档也说明,这些数字会随着提供商新增或取消免费层级而上下变化。今天的 1.53B tokens,不是下个月的保证值。
更现实的做法是把它当作“额度观察和路由工具”,每次使用前查看当前提供商、限速、模型可用性和条款,不要据此做硬性的业务容量承诺。
多账号和共享额度要看规则
为了叠加免费层级,有人会注册多个账号或共享凭据。但这可能违反提供商的服务条款,也会增加账号封禁、数据混用和凭据泄露风险。 OmniRoute 能管理路由,不能替你判断某种薅羊毛方式是否合法合规。
不同模型不是完全等价
自动切换后,模型的推理能力、工具调用、上下文长度、图像能力和代码质量都可能变化。简单问答问题影响不大,长上下文编程、数据库迁移和生产代码修改则需要固定模型或设置质量优先的路由策略。
本地运行不等于数据不会出网
OmniRoute 网关可以在本机运行,密钥也可以加密保存在本地。但请求一旦转发到云端提供商,提示词、代码和工具结果仍然会离开本机。
项目支持本地提供商,也提供了 PII 脱敏、凭据遮罩、请求限制等能力,但这些功能需要正确配置,不能把“local-first”理解成“所有数据都只在本地处理”。
适合谁
OmniRoute 适合:
- 经常使用 Claude Code 、 Codex 、 Cursor 、 Cline 等 AI 编程工具的人;
- 手里有多个模型账号,希望统一入口和自动切换的人;
- 愿意自己研究免费层级、额度周期和服务条款的折腾型用户;
- 希望在本机管理密钥、用量、预算和路由策略的小团队。
不太适合:
- 需要单一厂商提供稳定 SLA 的生产系统;
- 不想维护密钥、额度和模型配置的人;
- 不能接受不同模型之间存在质量差异的人;
- 需要把内部敏感数据直接交给陌生免费提供商的人。
许可与一句话判断
OmniRoute 当前仓库使用 MIT License,Node 版本要求和默认分支都在快速变化,安装前建议以 README 和最新发布版本为准。 GitHub API 当前显示仓库默认分支为 release/v3.8.50,公开 Release 列表中可见的版本为 v3.8.49,这也是需要留意项目更新节奏的原因。
一句话判断:OmniRoute 不是凭空制造免费模型,而是把分散的免费层级、订阅、 API Key 和低价模型集中到一个本地路由器里。喜欢薅羊毛的人确实会觉得方便,但真正省下来的不仅是钱,还有配置和切换的时间;至于额度是否可用、账号是否合规、数据是否适合发给某个提供商,最后仍然要自己判断。
来源链接: