
OmniParse:把 PDF、图片、音视频整理成 Markdown
一个本地运行的数据解析工具,把文档、图片、音频、视频和网页整理成适合 RAG 与 LLM 使用的 Markdown 或 JSON。
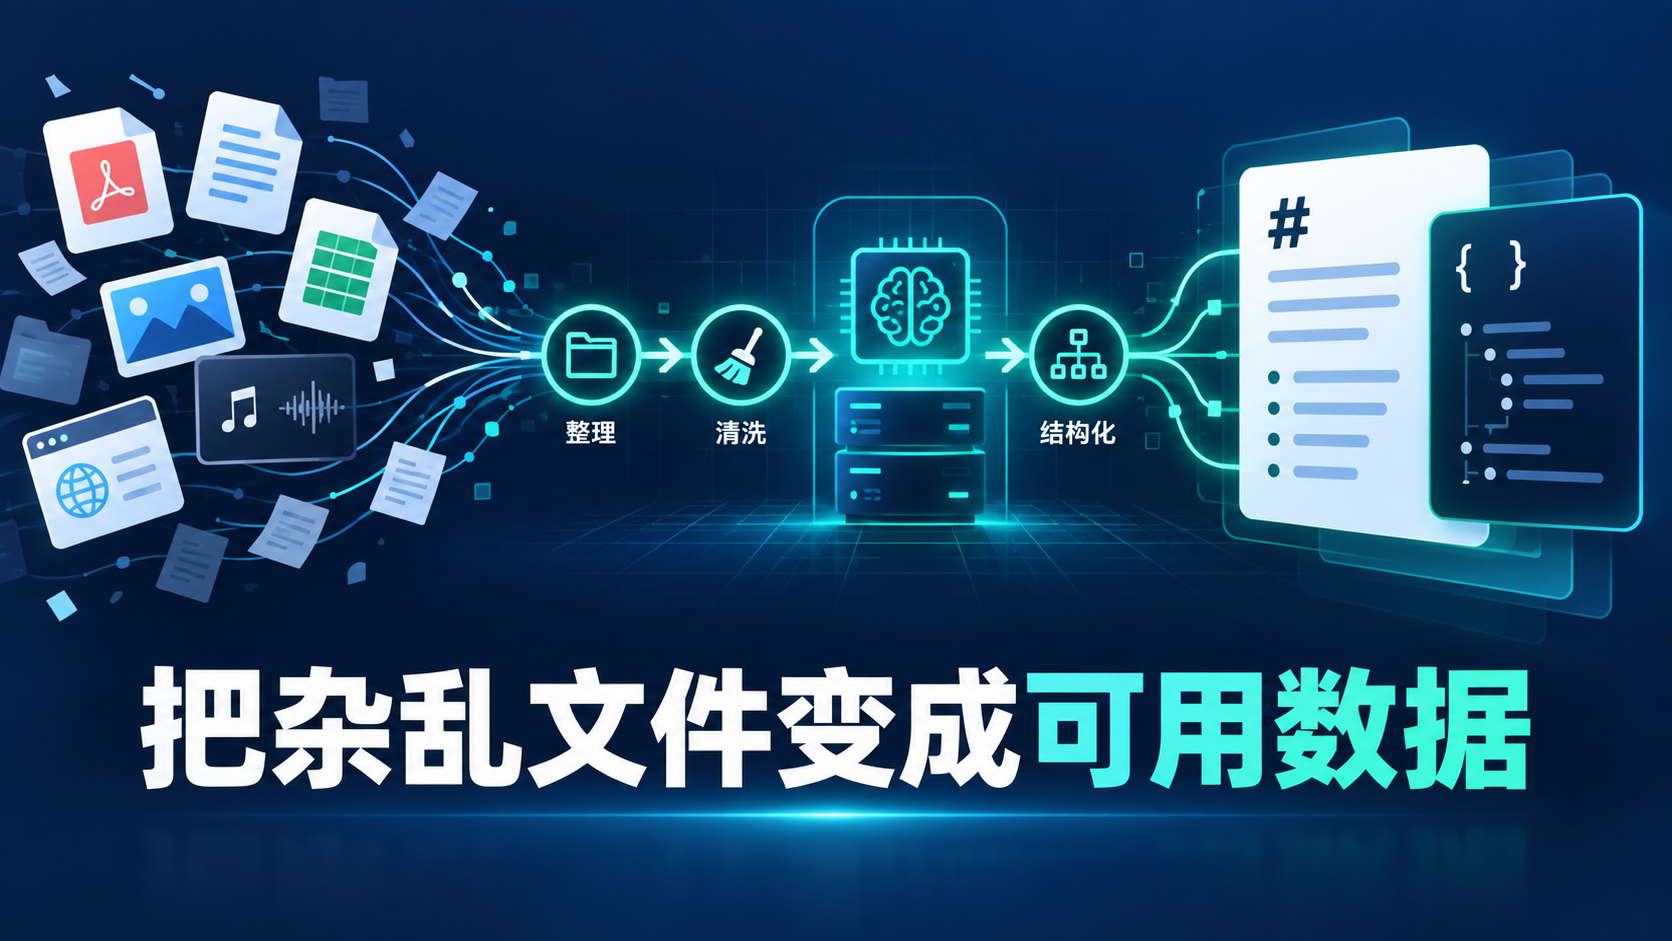
很多人第一次做 RAG,先卡在资料入口,模型反而排在后面。
PDF 里有表格,扫描件里有图片,会议录音在音频文件里,网页内容还会随着页面加载变化。把这些内容交给模型之前,得先把它们拆出来、转成文字、保住结构,再整理成模型能继续处理的格式。
OmniParse 做的就是这一层。它把文档、图片、音频、视频和网页作为输入,输出结构化 Markdown,也可以作为本地 API 接到后面的知识库或 LLM 流程里。
它能处理哪些内容
项目当前在 README 里列出了几类输入:
- 文档:
.doc、.docx、.pdf、.ppt、.pptx - 图片:
.png、.jpg、.jpeg、.tiff、.bmp、.heic - 视频:
.mp4、.mkv、.avi、.mov - 音频:
.mp3、.wav、.aac - 网页:动态网页和普通 HTTP 页面
对应的处理能力包括 OCR 、表格提取、图片描述、音频和视频转写,以及网页抓取。它还提供了一个 Gradio 界面,适合先在本地试几份文件,再决定要不要接进自己的流程。
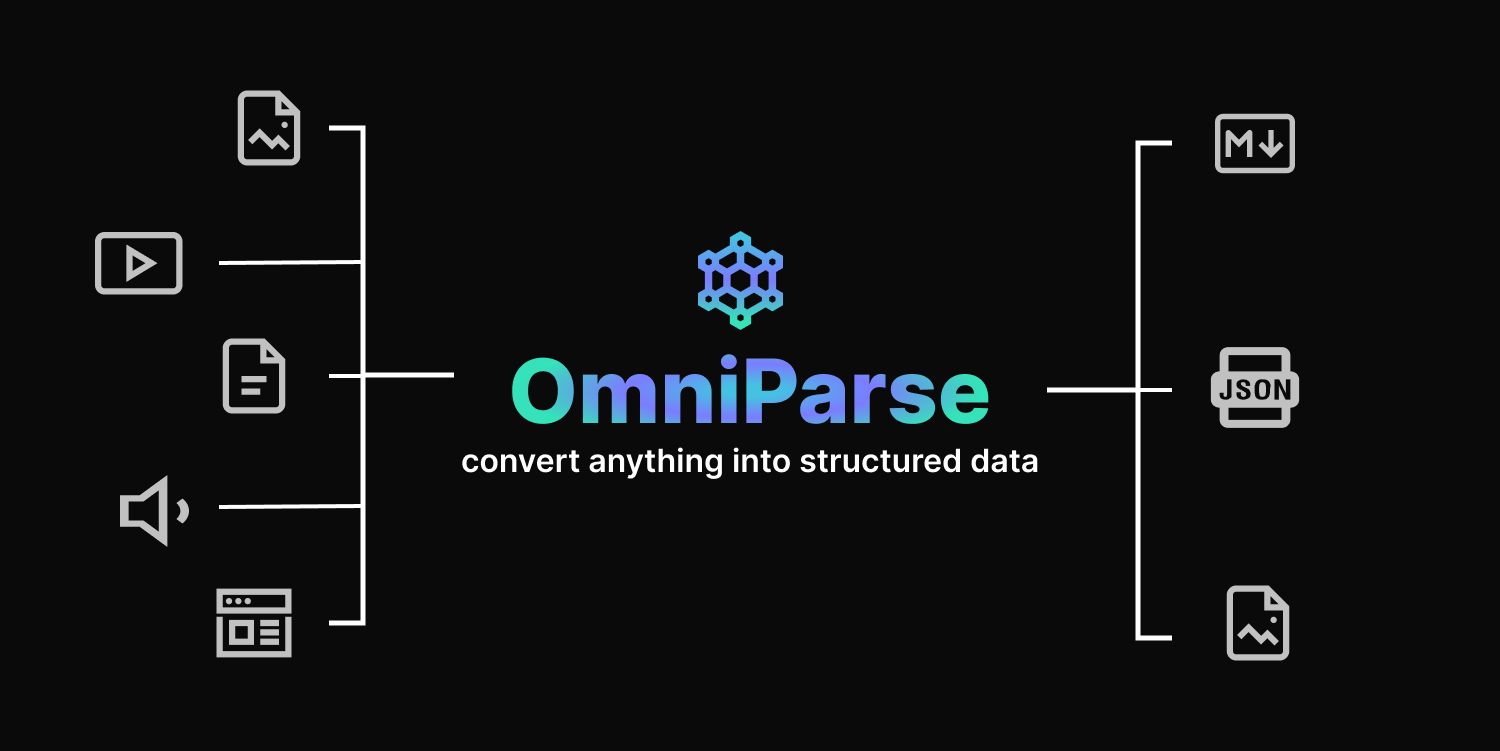
官方项目图把输入和输出画得很直白:左侧是图片、视频、文档、声音和网页,右侧是 Markdown 和 JSON 。
运行方式并不轻
OmniParse 的一大特点是完全本地运行,不依赖外部 API 。代价也写在项目限制里:需要一张至少约 8~10 GB 显存的 GPU 。 README 提到,项目尽量把模型放进 T4 GPU,因此使用的是较小的模型版本。
项目只支持 Linux 。 Windows 和 macOS 不在当前服务端支持范围内。它的依赖也不少,包含 PyTorch 、 Surya OCR 、 Florence-2 、 Whisper 、 Marker PDF 等组件。对普通电脑用户来说,Docker 或 Google Colab 会比手动配环境省事。
最小安装路径是:
git clone https://github.com/adithya-s-k/omniparse
cd omniparse

conda create -n omniparse-venv python=3.10
conda activate omniparse-venv

poetry install

# 或者
pip install -e .
启动服务时,可以按需要加载不同模块:
python server.py --host 0.0.0.0 --port 8000 --documents --media --web
这里的参数分别对应文档解析、音视频转写和网页抓取。模型也可以提前下载:
python download.py --documents --media --web
如果只想试一下效果,项目提供了 Google Colab 入口。已经有 NVIDIA GPU 的人,也可以直接使用项目 README 里给出的 Docker 镜像:
docker pull savatar101/omniparse:0.1

docker run --gpus all -p 8000:8000 savatar101/omniparse:0.1
API 适合接到什么流程里
OmniParse 目前暴露的是一组 FastAPI 接口。例如,解析 PDF 可以这样调用:
curl -X POST \
  -F "file=@/path/to/document.pdf" \
  http://localhost:8000/parse_document/pdf
解析图片时,可以调用图片接口:
curl -X POST \
  -F "file=@/path/to/image.jpg" \
  http://localhost:8000/parse_media/image
图片处理还支持 OCR 、图片描述、目标检测和区域描述等任务。视频和音频则分别走媒体接口,网页通过 JSON 传入 URL 。
这种接口形态适合放在一个简单的资料入库流程里:上传文件,调用解析服务,把返回结果存到 Markdown 或 JSON,再交给切分、向量化和检索模块。 OmniParse 负责的是“把资料变得可读”,它没有替你完成后面的知识库、权限、去重、版本管理和质量抽查。
几个限制,使用前要看
项目自己列出的限制比较具体。
第一,中文支持要谨慎。 README 明确写到,当前解析效果更偏向英文,中文文档可能出现识别或排版问题。
第二,表格不一定能保持原样。文本可能落到错误的列里,空格、缩进和行间关系也可能丢失。数字密集型财务表、复杂合同和多栏扫描件,建议保留人工抽查。
第三,PDF 公式转换并不保证完整。项目底层使用 Marker,公式需要先检测,再转成 LaTeX,遇到复杂版式时可能漏掉或转错。
第四,项目虽然说能装进 T4,但这不等于所有输入都能稳定处理。模型加载、文件大小、页面数量和并发任务都会影响显存占用和速度。 README 还列出了批处理、动态切块、按 Schema 提取等后续计划,当前版本不要按这些计划中的能力来设计生产流程。
适合谁
如果你有一台 Linux GPU 机器,手里又有一批 PDF 、图片、录音或网页资料,想把它们统一转成 Markdown 再接 RAG,OmniParse 值得试。
如果你只有普通办公电脑,或者主要处理中文扫描件,先用少量样本验证识别质量,再决定是否部署。对很多个人用户来说,先用 Colab 跑通一份文件,比直接在本地装完整依赖更稳。
项目仓库当前没有 GitHub Release,代码仓库标注的许可证是 GPL-3.0 。它还依赖 Marker 、 Surya OCR 等组件,模型权利和商业使用限制需要分别查看对应项目的许可证,不能只看 OmniParse 这一层。
项目地址:
https://github.com/adithya-s-k/omniparse
在线试用入口:
OmniParse 解决的是资料进入 AI 流程前的整理问题。它能省掉一部分手工搬运,但解析结果仍然要抽查,尤其是中文、表格、公式和扫描件。