
体检单、手环数据,终于可以放进同一个 AI 健康档案了
Mirobody 是一个开源的健康数据引擎:把体检报告、穿戴设备和其他健康记录统一成 AI 能读懂的标准格式,再用自然语言查询趋势。它适合想整理个人或家人健康数据的人,但不能替代医生,也不等于数据天然安全。
家里的体检报告可能是 PDF,手环数据在手机健康应用里,医院系统又是另一套字段。你想问一句“这两年糖化血红蛋白有什么变化”,第一步往往不是分析,而是先把数据找齐、抄出来、改成同一种格式。
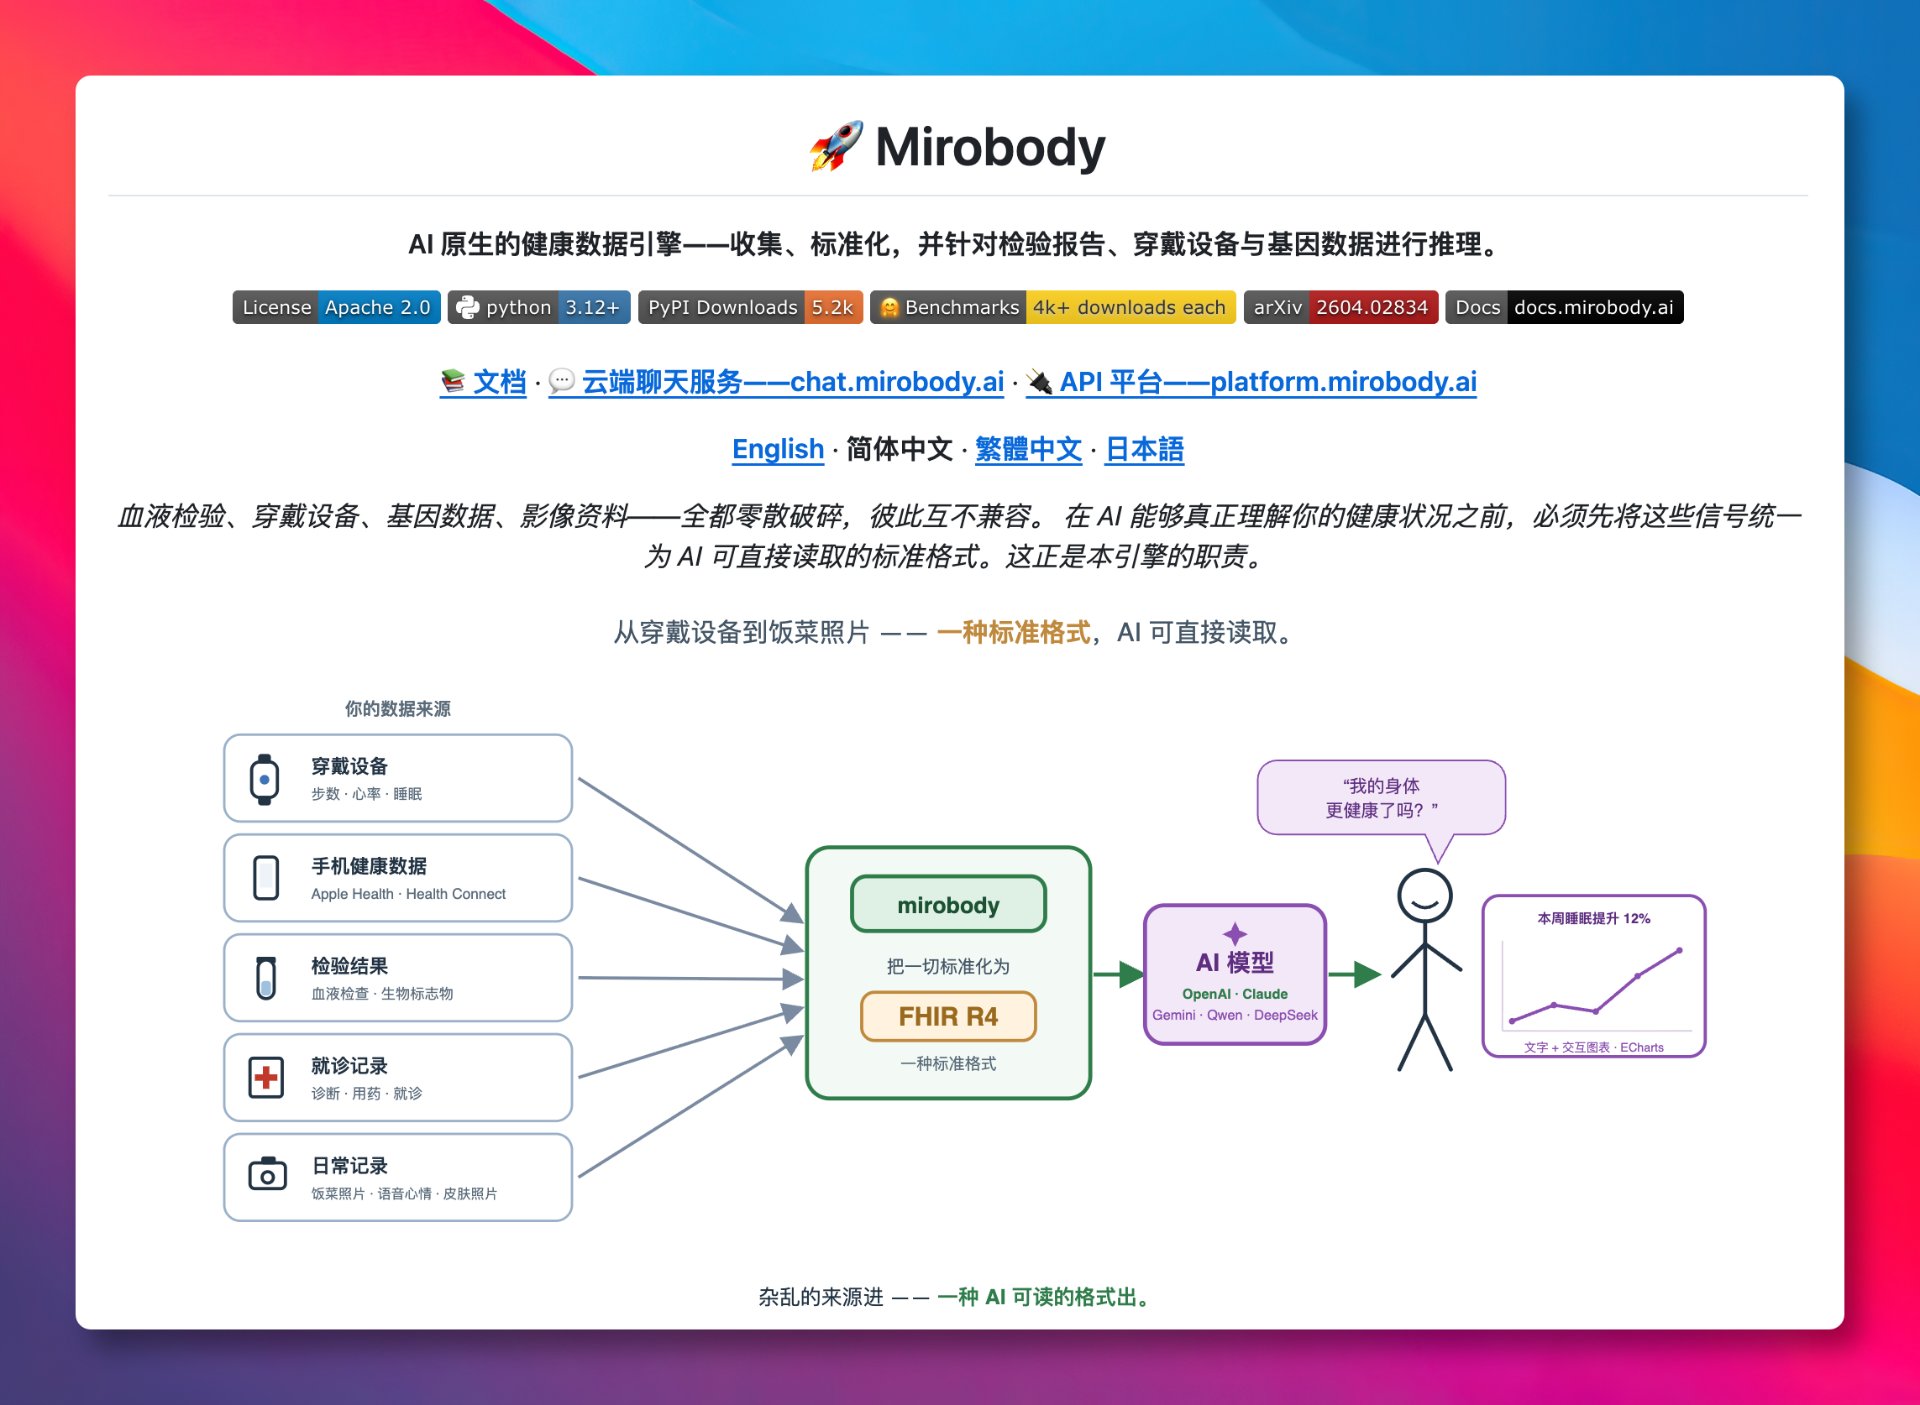
Mirobody 解决的是这层麻烦。它把体检报告、穿戴设备、影像和其他健康记录收集到一起,转换成统一的医疗数据格式,再交给 AI 查询和整理。
它不是一个单纯的聊天机器人,更像是 AI 健康问答前面的数据整理层。没有统一的数据,AI 再会说,也只能对着几张零散的报告做猜测。
它具体做哪三件事
Mirobody 的代码和文档围绕三步展开:收集、标准化、回答。
1. 收集健康数据
项目支持 Apple Health 等设备数据,也支持多种医疗文件。 README 目前列出的范围包括 3 类设备或数据提供方、 1 个 SQL 数据源和 7 类文件格式。
对普通用户来说,可以把它理解为一个入口:穿戴设备记录的步数、心率、睡眠,医院给出的检验单,以及日常上传的健康文件,都有机会进入同一套数据系统。
2. 把不同写法归到同一个标准
同一个指标,医院之间可能写法不同,中文、英文、繁体中文和日文也可能各写各的。 Mirobody 使用 LOINC 、 SNOMED CT 、 RxNorm 等医疗术语体系,并把数据落到 FHIR 认可的结构上;单位则按照 UCUM 规则处理。
例如“血红蛋白”、hemoglobin、“血紅素”和“ヘモグロビン”,可以归到同一个 LOINC 编码。总胆固醇如果带上不同单位,也不会简单地被当成同一个数字。
这一步最值得注意的地方,是它宁愿留空,也不强行猜。一个没有把握的指标,如果被错误地归类,后面的趋势图和问答都会建立在错误数据上。
3. 让 AI 查询这些数据
数据统一后,你可以用自然语言提问,比如:
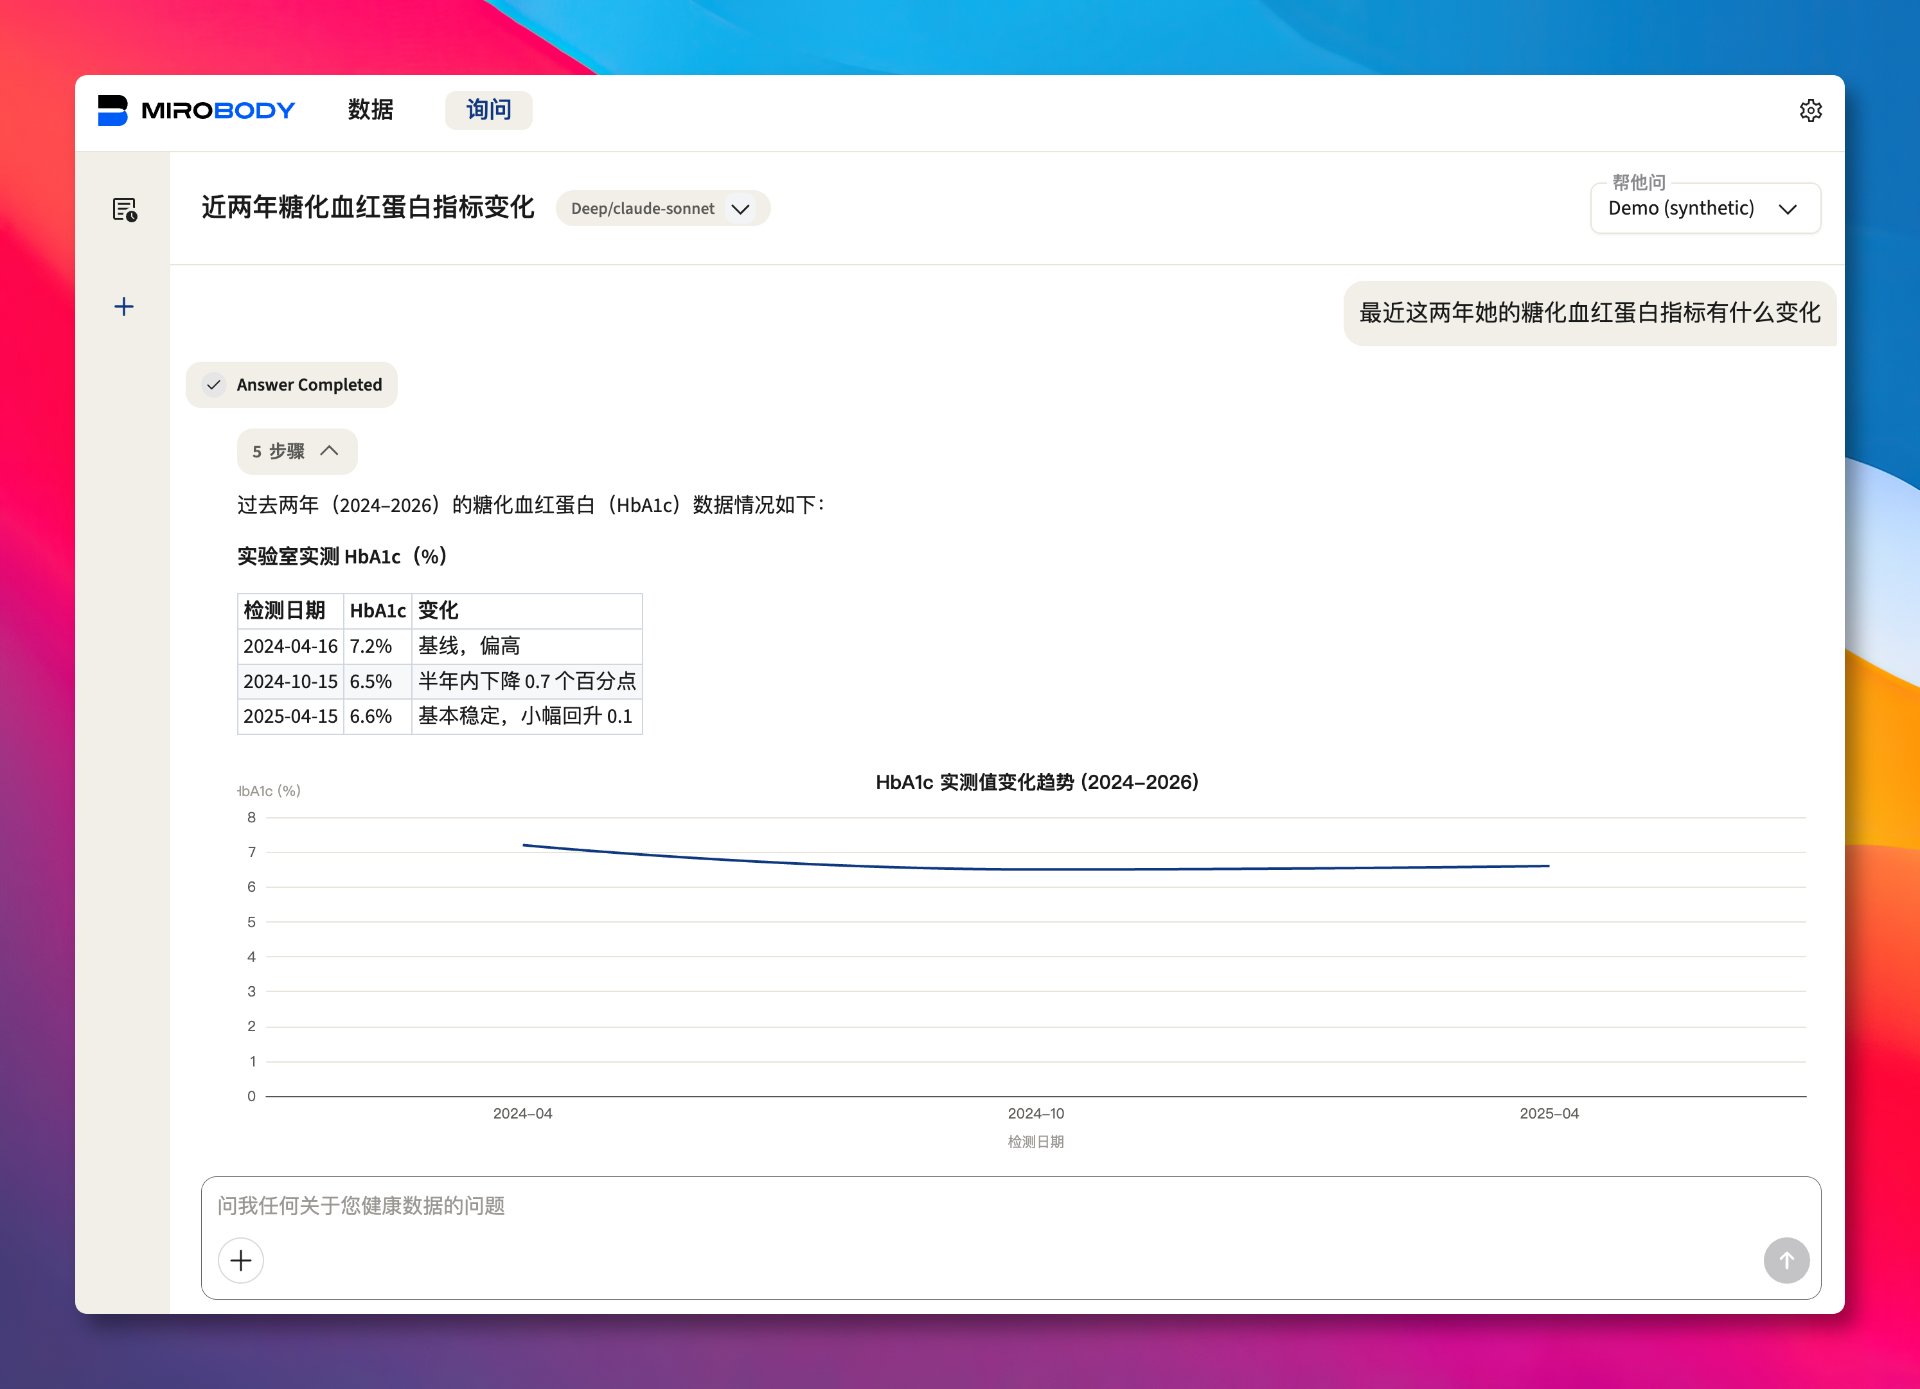
近两年糖化血红蛋白有什么变化?
系统会从健康记录里查找相关数据,整理成表格或趋势图,并标注它使用了哪些数据。项目展示的示例中,系统同时查看实验室检测值和设备推导出的数据,给出变化曲线。
这个项目和普通 AI 问答差在哪
直接把体检报告丢给聊天机器人,确实可以得到一次性的解释,但它通常不知道你半年前的另一份报告,也不知道不同文件里“血糖”“GLU”和“空腹血糖”是不是同一个概念。
Mirobody 先建立健康数据层,再让 AI 在这层数据上工作。这样做的好处有两个:
- 同一个指标可以跨报告、跨设备进行比较;
- AI 回答时可以回到具体数据,而不是只凭一份文件的上下文。
项目还把解析出来的文件放进虚拟文件系统,供 Agent 读取。换句话说,AI 不只是看一段已经复制好的文字,还可以按任务去查找文件、指标和时间范围。
不过,标准化并不会自动让数据变得正确。设备推算值和医院检测值本来就不是同一种测量方式,项目能把它们整理到一起,但你仍然要看清数据来源和测量条件。
它的标准化能力有多细
仓库目前提供了一个离线指标解析器,安装后可以直接试:
pip install mirobody
mirobody resolve "LDL cholesterol" 血红蛋白 ヘモグロビン "空腹血糖(GLU)" 血脂
它不需要 API Key,也不需要联网。项目给出的示例可以把不同语言的指标映射到标准编码,也会区分“一个具体观测值”和“血脂”这样的分类词。
这里有一个很重要的边界:resolve 主要解决术语和单位归一化,不是医疗诊断。它能告诉你一个指标更接近哪个标准概念,不能据此判断你是否患有某种疾病。
项目还提供可选的语义检索层,用来给出可能的候选编码。但仓库明确提醒,这种相似度搜索不能自动判断正确与否,陌生词可能会被匹配到一个看起来很像、实际上不对的概念。因此,语义检索更适合给人提供候选项,不能让它直接生成最终医疗身份。
能不能把家人的数据也放进去
Mirobody 设计了“关爱圈”功能。家人可以邀请你加入,再决定你能不能查看自己的健康记录或对方的记录。
这个权限设计值得单独说出来:加入关爱圈不等于自动获得所有数据权限。仓库里的规则把健康访问权限单独存储,并在没有权限时返回拒绝结果。
对于父母的体检报告,这种模式比把文件丢进一个家庭群更清楚。谁拥有记录、谁可以查看、谁可以操作,都应该有明确的边界。
但自建系统并不意味着隐私问题自动消失。你还需要考虑服务器是否暴露在公网、数据库和备份是否加密、模型 API 会不会接触健康信息,以及家人账号被盗后会发生什么。
部署方式:先试轻量版,再决定要不要搭完整系统
如果只是想试试指标标准化,可以先用 Python 包。项目的离线解析能力适合做一个小实验:拿几种写法不同的指标,看看它们是否能归到正确的编码。
如果要运行完整应用,仓库提供 Docker 部署方式:
git clone https://github.com/thetahealth/mirobody.git
cd mirobody
git lfs pull
./deploy.sh
完整部署会启动数据库、向量数据库、 Redis 、服务端和后台任务。项目文档给出的本地地址是 http://localhost:18060。
要让聊天、视觉解析和语义搜索真正工作,还需要配置大模型或嵌入模型的 API 。仓库示例使用 OpenRouter,也说明了 DashScope 等兼容方案。 API Key 应该放在 Docker 使用的环境配置里,而不是只在宿主机临时执行 export。
这一点对国内用户比较实际:如果某个海外服务连接不稳定,可以考虑使用自己能访问的兼容服务;但无论使用哪家,都要先确认健康数据是否会发送到第三方服务器,以及服务商如何保存和处理这些数据。
项目现在适合谁
Mirobody 比较适合以下几类人:
- 家里有多年的体检报告,想按时间整理;
- 经常使用智能手表,希望把设备数据和检验数据放在一起;
- 想学习 FHIR 、 LOINC 、医疗数据标准化和 AI Agent 的开发者;
- 有能力维护 Docker 、数据库和 API Key 的个人或小团队。
如果你只是偶尔看一次体检单,或者不愿意维护本地服务,直接使用医院提供的健康平台可能更省事。完整部署还涉及数据库、备份、权限和模型服务,不能把“开源”理解成“装上就不用管”。
还有几个必须看清的限制
第一,项目 README 里的用户数、下载量和评测数据属于仓库自身展示的信息,不能当成医疗效果证明。它证明的是项目正在建设和有人使用,不代表 AI 给出的健康建议一定正确。
第二,项目支持解析文件,不代表它能准确读懂所有医院格式。扫描质量、表格布局、单位和参考范围都会影响结果。重要指标应当回到报告原件核对。
第三,AI 只能帮你整理趋势和解释数据,不能替代医生诊断,也不能替你决定是否停药、换药或改变治疗方案。
第四,健康数据是高度敏感的信息。即使服务部署在自己的电脑上,也要检查日志、备份、远程访问、模型接口和家庭成员权限。
值不值得试
如果你的痛点是“数据太散,问一个趋势要翻好几份报告”,Mirobody 的思路是对的:先把指标、单位和来源整理清楚,再让 AI 回答。
建议从最小范围开始。先用几条不敏感的测试数据跑通指标解析,再决定是否接入真实报告;如果要接入家人的数据,先把权限和备份方案写清楚;如果要接入云端模型,先确认数据会不会离开自己的设备。
它最有价值的地方不是让 AI 说得更像医生,而是让 AI 终于有机会面对一份结构清楚、来源明确、能按时间比较的健康档案。
项目地址:thetahealth/mirobody
文中健康数据仅用于说明软件工作方式,不能替代专业医疗意见。