
没有公开 API,AI 能帮你接上吗?Integuru 的能力与边界
Integuru 能分析浏览器网络请求,把经过授权的操作流程整理成可运行的 Python 集成代码。但它不是绕过权限的工具,网页能访问也不等于你获得了调用和自动化的许可。
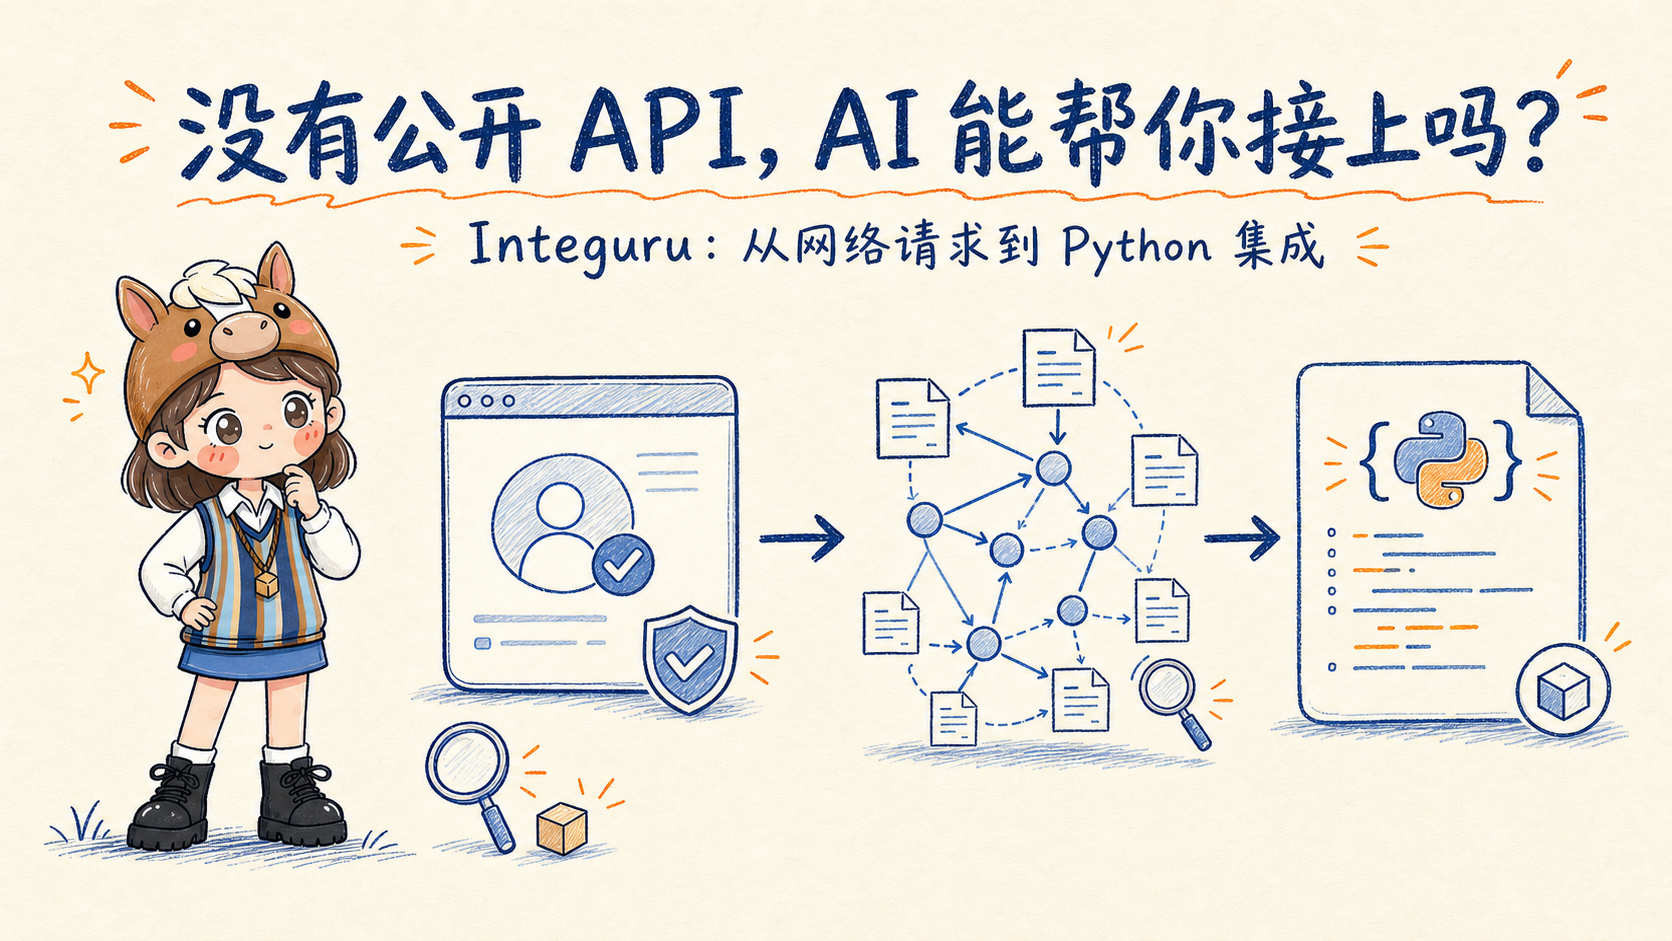
很多网站没有公开 API,但网页本身可以完成登录、查询、下载和提交。过去要把这些操作自动化,通常得用 Selenium 或 Puppeteer,让浏览器一直开着,模拟点击,再处理各种等待和页面变化。
Integuru 走的是另一条路:先观察一次经过授权的浏览器网络请求,再让 AI Agent 分析这些请求之间的依赖关系,最后生成不需要启动浏览器的 Python 集成代码。
听起来像“把网页变成 API”,但这里有一个必须先说清楚的前提:网页能访问,不等于你有权绕过平台的公开接口限制。 Integuru 适合处理你拥有权限、明确允许自动化的系统,不适合拿来绕过登录、验证码、访问控制或服务条款。
Integuru 是什么
Integuru-AI/Integuru 是一个开源 Python 项目。当前 GitHub 仓库的 README 把它定位为早期公开版本,展示最初的实现方式;最新产品已经转移到 Integuru 官网。
这个早期版本的核心工作可以拆成三步:
- 记录浏览器执行某项操作时产生的网络请求;
- 找出请求之间的依赖,例如某个下载请求需要先拿到账号 ID 或临时参数;
- 根据依赖图生成可以直接运行的 Python 代码。
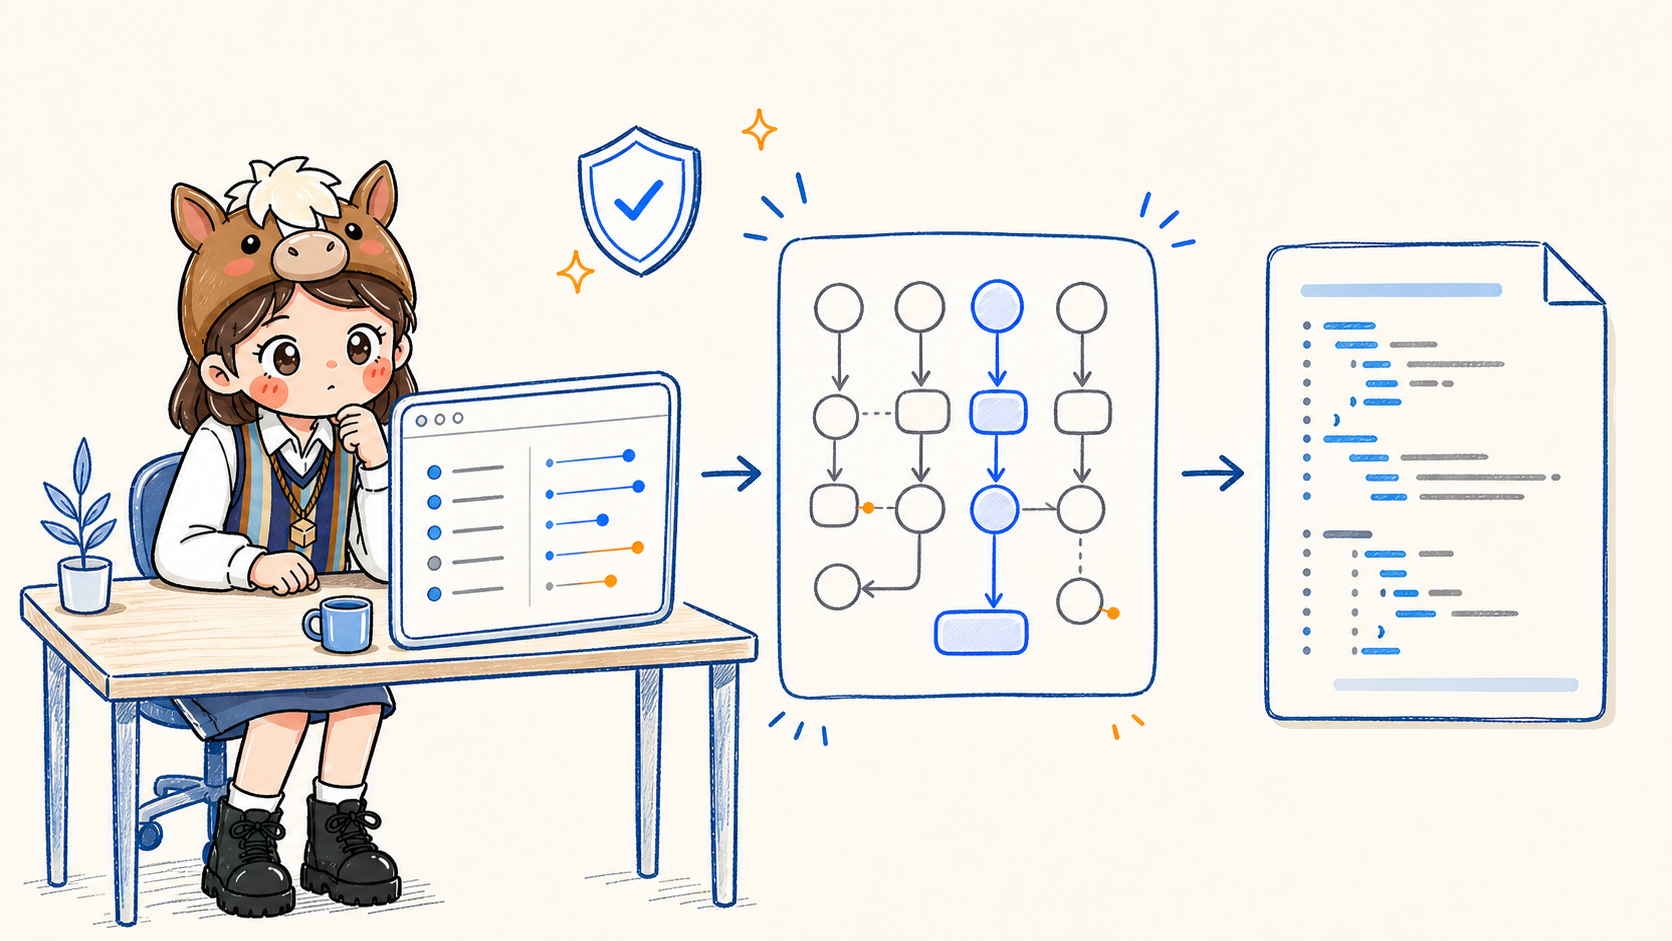
它不是把页面上的按钮“录制”下来,而是尝试理解按钮背后真正调用了哪些接口,以及这些接口需要什么参数。
它能做什么
1. 生成请求依赖图
以“下载账单”为例,目标请求可能需要 accountId、userId 或其他动态参数。 Integuru 会继续寻找这些参数由哪个请求返回,再把前置请求连接起来,形成一张依赖图。
这样做的好处是,自动化代码不必把某次抓包里的固定值写死,而是可以先获取前置数据,再调用最终接口。
2. 生成可运行的 Python 集成
仓库的目标不是返回一张分析报告,而是生成可以执行的 Python 代码。代码会按依赖顺序发起请求,完成目标操作。
对于内部系统、合作方后台或已经得到明确授权的业务平台,这种方式可以减少浏览器自动化的维护成本。系统不需要等待页面渲染,也不依赖按钮位置和前端 DOM 结构。
3. 让 LLM 参与逆向分析
项目使用 LangChain 、 LangGraph 和 OpenAI 模型来分析 HAR 文件、推导请求关系并生成代码。 README 建议使用具备函数调用能力的模型做图生成,代码生成则依赖更强的模型能力。
这也意味着它不是完全离线的本地工具。按照仓库的隐私说明,网络请求记录和 Cookie 文件保存在本地,但分析过程使用云端 LLM 。只要 HAR 或 Cookie 中包含敏感信息,就必须先评估脱敏、数据出境和凭据泄露风险。
最小上手路径
仓库当前的公开 v0 版本要求 Python >=3.12,<3.13,使用 Poetry 管理依赖。
安装依赖:
poetry install
poetry shell
设置模型 API Key:
export OPENAI_API_KEY="你的 API Key"
然后在你有权操作的平台上,记录一次网络请求。仓库提供了 create_har.py,用于启动浏览器并生成网络请求记录。完成一次合法的业务操作后,再让 Integuru 分析目标动作:
poetry run python create_har.py
poetry run integuru --prompt "download utility bills" --model gpt-4o
命令行还支持指定 HAR 文件、 Cookie 文件、最大步骤数和输入变量。运行前要先确认两件事:一是 Cookie 不会被提交到不该去的地方,二是目标平台和目标动作都允许这类自动化。
当前项目的快速体验更像研究原型,而不是开箱即用的商业连接器。官网已经是新的产品入口,仓库 README 则明确写着它保留的是最早公开版本。
它不能替你解决什么
不能把没有权限的操作变合法
生成出 Python 代码,不代表调用就获得了授权。平台可能禁止自动化访问,也可能要求使用官方 API 、合作协议或特定的服务账号。不要把“没有公开 API”理解成“可以自己找内部接口调用”。
不能保证生成代码长期可用
内部接口可能随时修改参数、鉴权流程、请求头和返回结构。一次抓包成功,只能说明当时的流程可被复现。要投入生产,还需要测试、版本监控、失败重试、限流、审计和人工接管。
不能消除凭据风险
HAR 文件可能包含完整请求头、查询参数和 Cookie 。cookies.json 更是敏感凭据。它们不应进入 Git,不应通过聊天工具转发,也不应直接上传到第三方服务。完成分析后,要按组织的凭据管理规则保存、轮换或删除。
不能替代官方 API 的稳定性
官方 API 通常会给出版本、配额、错误码和兼容承诺。基于网页内部请求生成的集成,更多依赖当前实现。它可以作为授权场景下的补充,但不应自动被当成官方接口的等价物。
适合谁
Integuru 更适合:
- 需要连接内部系统或已获授权的合作平台的工程团队;
- 想研究“浏览器操作背后到底发了哪些请求”的开发者;
- 已经有测试、凭据管理和接口变更监控能力,愿意维护非官方集成的人。
它不适合:
- 想绕过登录、验证码、订阅限制或访问控制的人;
- 没有权限处理目标网站数据的人;
- 只想快速抓取一个页面、却不愿意承担凭据和合规责任的使用者。
许可与项目状态
GitHub API 和仓库根目录 LICENSE 都显示,Integuru 使用 GNU Affero General Public License v3.0,也就是 AGPL-3.0 。它不是“随便拿来闭源集成”的宽松许可证,修改、再分发和通过网络提供服务时,都需要认真阅读对应义务。
另一个容易被忽略的事实是:GitHub 上的 v0 仓库并不等于官网当前产品。仓库 README 自己说明,这里保留的是最早公开版本,当前版本请看 integuru.com。如果准备在团队里采用,先确认你评估的是开源 v0 代码,还是官网提供的商业产品和服务。
一句话判断:Integuru 的价值,是把一次经过授权的浏览器操作,整理成更轻量的请求级集成;它的风险,也恰恰来自这些请求里可能包含权限、凭据和平台规则。技术上能做,不代表业务上该做。真正上线前,授权、脱敏、测试和维护一个都不能少。
来源链接: