
评估工程:构建一个让 Agent 无需人工审查也能合并的闸门
当 Agent 完成一次修改后,系统怎样根据证据决定它能否继续合并?这套 6 步方法从评估偏差、轨迹评分、日志测试到风险闸门,搭建一套可执行的 Agent 合并机制。
最终状态很容易描述:Agent 完成一次修改,提交它,然后修改自动进入主分支,不需要人工逐行阅读。
这不是因为谁决定相信模型,而是因为一个闸门读取了证据,并且知道应该遵守什么规则。
几乎没有团队真正拥有这样的闸门,原因也不是缺少勇气。
大多数系统里,闸门需要读取的证据还不存在。
在打开这道闸门之前,下面六件事必须先成立。
第 1 步:你读取的分数,有一部分来自评判者本身
自动评估最初确实带来了可靠的结果。
2023 年,UC Berkeley 的 Zheng 及其同事展示了 GPT-4 与人工评分者超过 80% 的一致率,大致相当于人类评分者彼此之间的一致率。之后,整个行业几乎一夜之间转向 API 调用。
后续研究发现,评判者会对眼前内容之外的因素做出反应。
前沿模型评判者会系统性地抬高同一模型家族输出的分数。
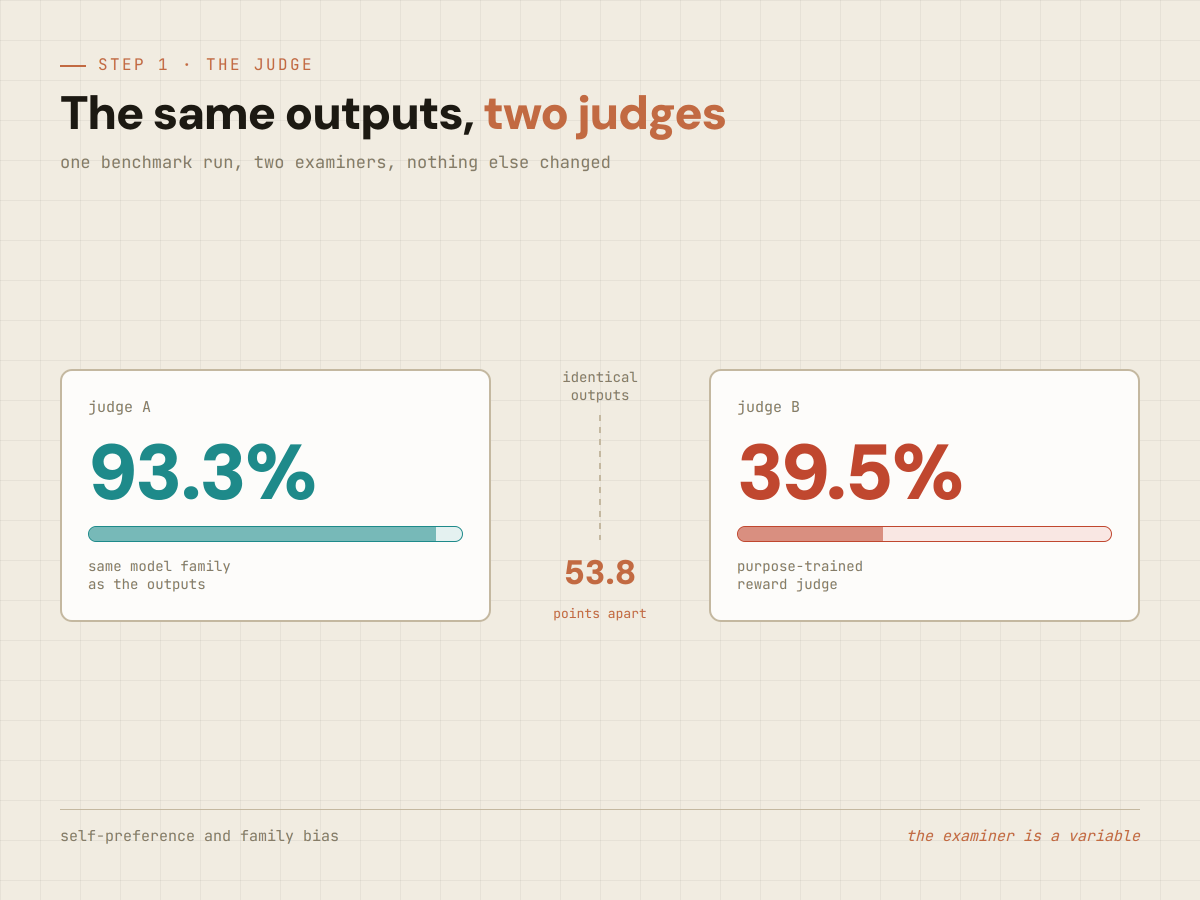
在一项 2026 年的基准测试中,GPT-5.2 和 Gemini 3.1 Pro 给自己所属的模型家族打出了 75% 到 84% 的胜率。 Claude Opus 4.7 的表现则相反,它对自己所属家族的评分偏低,只有 10.6% 到 41.2% 。
在 ArenaHard 上,不同评判者之间测得的偏差范围从 -38% 到 +90% 。
同一组输出交给两个不同评判者后,结果也可能完全不同:在一个评判者那里得分 93.3%,在另一个评判者那里,完全相同的输出只有 39.5% 。
冗长偏差也同时存在:评判者会奖励更长的回答,即使多出来的文字没有增加任何信息。
这并不意味着这种方法没有用,而是说明评估配置本身承载了大量风险。下面三条规则可以覆盖大部分问题:
- 生成内容的模型和评判模型,尽量使用不同模型家族。使用同一家族,意味着共享盲点。
- 对高风险任务,使用来自不同厂商的评判者组成评判面板,不要只依赖一个评判者。跨模型家族取平均,才能削弱相关性错误。
- 能够客观检查的事情交给代码,不要交给评判者。测试是否通过、文件是否存在、状态是否发生变化,都应该由程序确认。
由带偏见的评判者供给证据的闸门,比没有闸门更糟糕。
它会把一个猜测洗成一个数字,然后依据这个数字采取行动。
第 2 步:不会改变运行过程的判定,只是一份报告
大多数团队会停在这一步之前。
他们得到一个分数,把它放进仪表盘,但仪表盘并没有改变任何人的行为。
2026 年逐渐成熟的一种做法,是把评估放进 Agent 的运行过程,而不是等运行结束后再评估。生产前的评估被提升为生产环境中的护栏,分数会控制 Agent 下一步能做什么:它可以访问哪些工具、一次交接是否被接受、运行是否需要升级给人工处理。
这就是温度计和恒温器的区别。
每个判定都应该映射到当前运行过程中的一个结构性动作。
- 接地程度不足,拒绝这次交接。
- Schema 校验失败,阻断这条边。
- 怀疑存在虚构内容,就隔离这条分支,不让它合并进主流程。
- 只有经过验证的完成状态,才允许结束运行。
一个 Agent 停止调用工具,只能说明它结束了当前轮次。它不等于任务已经完成,只有外部检查才能确认这两者的区别。
这就是第一种可以复用的能力:如果系统里的判定已经能够控制运行过程,那么这些判定就值得在合并时继续读取。
第 3 步:评估路径,不只评估答案
只看最终回答,会让 Agent 通过一条错误的过程得到正确答案,而团队可能一个月都发现不了。
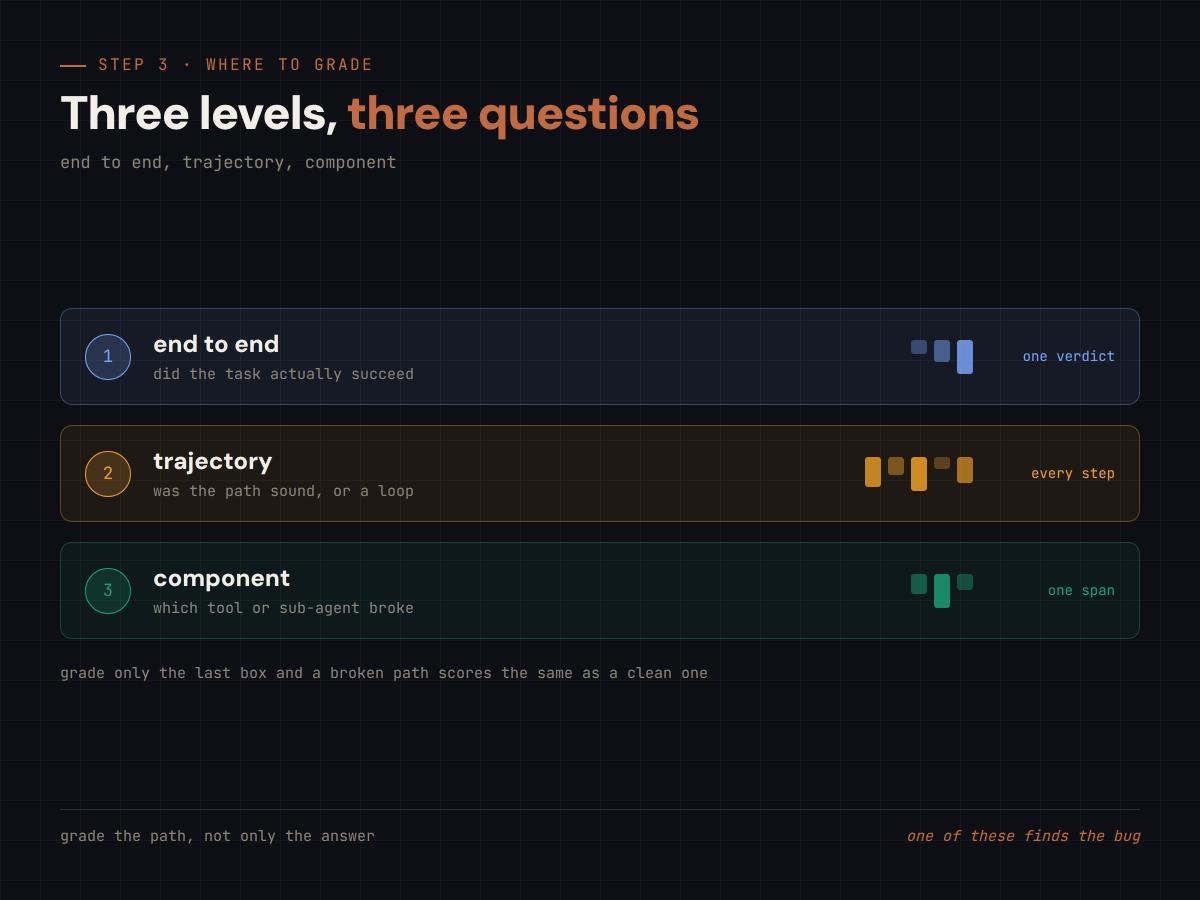
Agent 评估分成三个层级,三个层级都需要保留:
- 端到端层级:任务是否成功。
- 轨迹层级:过程是否合理。循环调用、重复调用和浪费步骤,都会在这里暴露出来。
- 组件层级:哪个检索器、工具或子 Agent 出了问题。只有这一层能告诉你应该去哪里修复。
一开始,三个指标就够了:
- 忠实性:回答是否建立在工具实际返回的内容上,而不是工具返回空结果后,模型自行补全出来的内容。
- 工具参数准确性:是否使用了正确的工具,并传入了正确的参数。
- 任务完成度:是否依据真实信号判断任务完成,而不是依据 Agent 自己的声明。
最容易隐藏的是忠实性。一个 Agent 写得很流畅,还编造了汇率,可能在质量面板的所有指标上都得到高分;直到客户按照这个汇率采取行动,问题才会暴露。
对闸门来说,轨迹比最终答案更重要。
一次修改即使最终 diff 完全相同,如果它经过了四十步反复试错才到达,和沿着干净路径到达的修改,风险并不一样。
第 4 步:最好的测试已经在日志里
坐在桌前凭空设计的测试,只能防住你已经想象到的失败。
代价最高的失败,此刻就躺在你的运行轨迹里,而且带着时间戳。
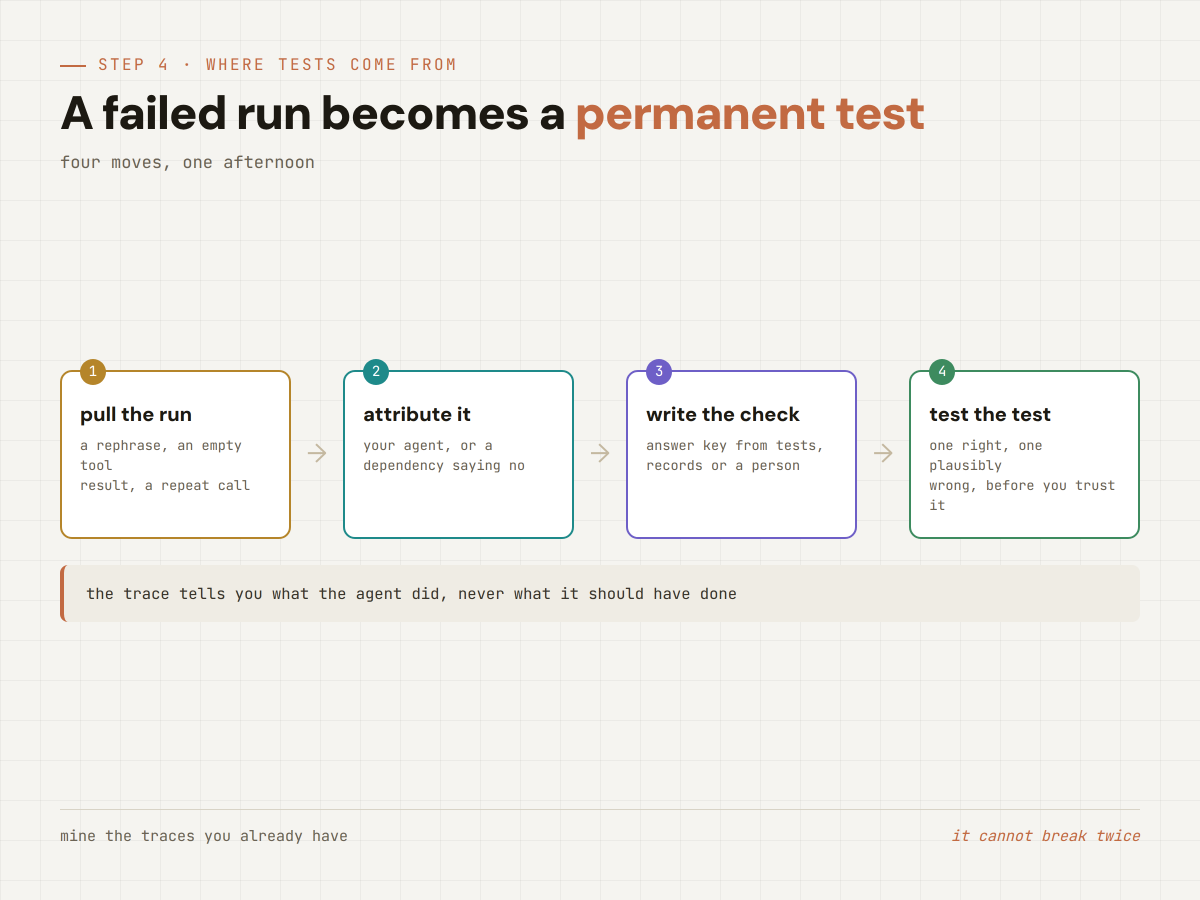
抽取一小组完整运行记录,让正常行为和异常行为彼此靠近:
一次干净结束的请求,把它作为“正常工作”的基线。
一次用户重新表述或纠正的请求,因为这次纠正本身就是免费的标签。
一次工具返回空结果,或者相同参数被重复调用的运行。
一次外部服务超时的运行,这里要测试的是 Agent 在外部世界说“不”时如何行动。
每个案例用四行写清楚:Agent 做了什么;哪些地方有效、哪些地方无效;原因来自 Agent 还是来自依赖;评估需要保护哪种能力。
归因是最容易让人浪费一周时间的地方。
同样的查询使用完全相同的参数调用两次,说明 Agent 出现了循环。
返回限流是外部依赖的问题,只有当 Agent 本来就应该从限流中恢复时,它才属于你的评估范围。
两条规则可以让这个过程保持诚实。
运行轨迹只能告诉你 Agent 做了什么,不能告诉你它本来应该做什么。答案标准必须来自测试、记录、政策或人工判断。
同时,在信任验证器之前先测试验证器本身。给它一个明确正确的结果,再给它一个看起来合理但实际错误的结果。如果其中任何一个被判错,坏的不是 Agent,而是评估标准。
每一个这样转化出来的失败,都会变成闸门无法第二次意外遇到的问题。
第 5 步:固定评判者,否则这个月的分数就失去意义
评判者也是有版本的软件。
一个悄悄升级的评判者,会让升级前后的所有分数失去可比性。
这种失败很安静:评判者某个月升级了一个小版本,下个月又升级了一个大版本,评估套件仍然在持续产出数字,但这些数字几周前就已经不再表示同一件事。
固定版本,并且把版本号和每个分数一起记录下来。
把评估标准写成一行,格式应该是:当一个独立可观察的结果发生时,通过。不要把一堆代理指标捆在一起。
也不要奖励回答的外形。回答更长、包含更多关键词、引用更多、或者更像参考答案,都不应该自动获得分数。
这不是风格偏好。
如果针对评判者进行足够强的优化,Agent 学会的就会是“看起来正确”,而不是“确实正确”。这会把你的防御层变成攻击面,也就是模型参与下的古德哈特定律。
在依赖自我复核之前,还有一件事需要知道。
DeepMind 的 Huang 及其同事在 ICLR 2024 展示过:如果没有外部依据,只是要求模型自己审查并修改自己的工作,内在自我纠错并不能稳定改善结果,很多时候反而会让结果变差。
依据必须来自模型之外。
让评估套件经得住真实运行。
2026 年的工作建议是,在信任一个聚合数字之前,至少准备 500 个案例,同时让一次运行短到不会有人开始围绕它做计划。
如果一套评估耗时超过一杯咖啡的时间,它最后会变成一个季度才运行一次的仪式。
第 6 步:根据影响范围打开闸门,不要根据信心打开闸门
很多说明在这里走错了方向。
它们构建一个信心分数,设置一个阈值,然后让所有超过阈值的修改通过。
信心是这个决策里最弱的变量。
更可靠的变量是:如果这次修改错了,后果是什么。
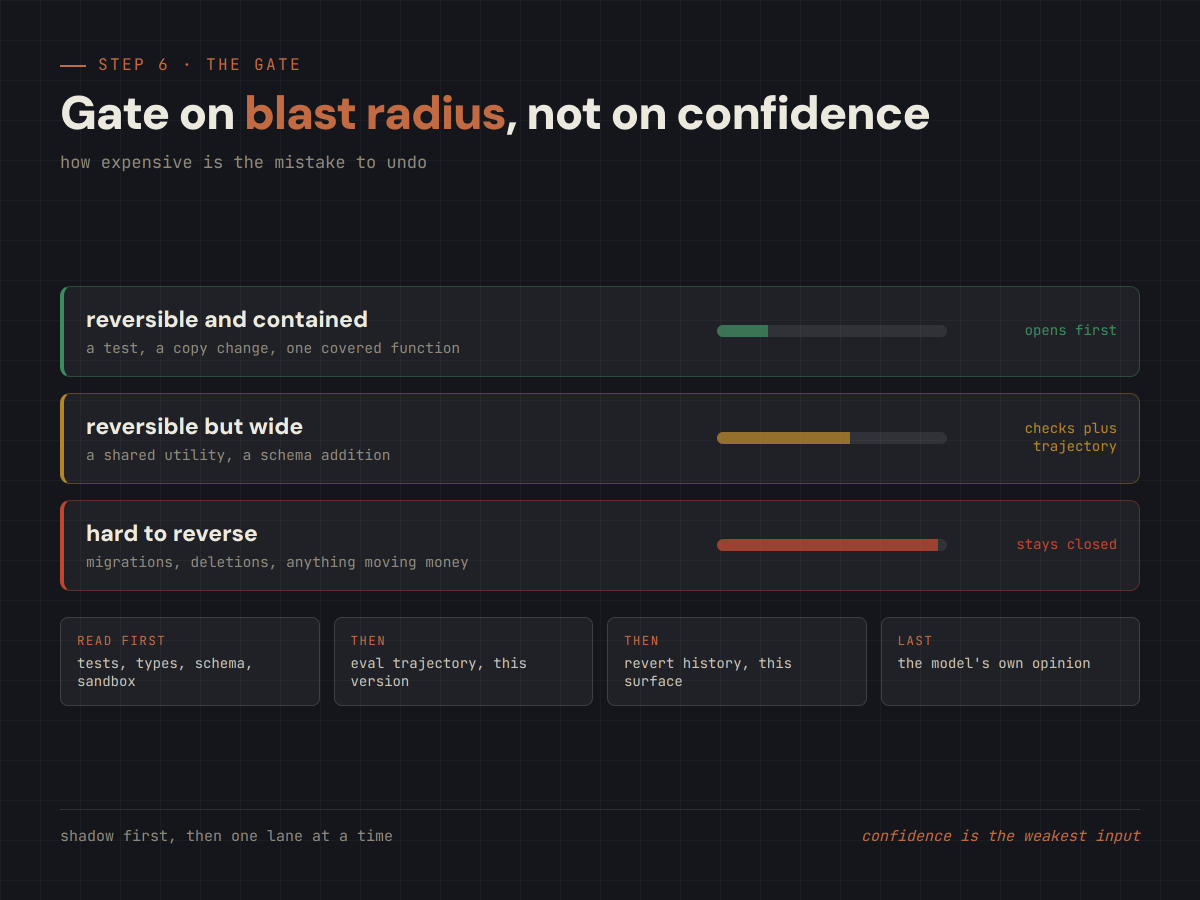
按照错误修复的代价,把工作分成不同通道,并为每个通道设置不同的闸门:
- 可回滚且影响范围小:文案修改、测试、带覆盖率的独立函数。一次错误合并最多需要回滚,这条通道可以最先开放。
- 可回滚但影响范围大:共享工具、 Schema 增加,以及任何会被十几个调用方使用的修改。这条通道需要通过确定性检查,并且拥有干净的运行轨迹。
- 难以回滚:迁移、删除、任何会写入生产数据或移动资金的操作。无论分数多高,这条通道都不应该开放。
在已经开放的通道里,闸门读取的是证据,而不是意见。
先看确定性结果,因为这里不涉及模型:测试、类型、 Schema 和沙箱执行。
然后看当前 Agent 版本的评估轨迹。
再看历史,也就是这个 Agent 在这个代码表面上的工作过去被回滚过多少次。
Agent 自己的评估应该是闸门权重最低的输入,因为这是唯一一个 Agent 可以直接影响的输入。
谨慎地打开它。
先以影子模式运行,让闸门给每次修改评分,但不自动合并任何修改,直到拥有足够真实流量可以进行比较。
记录闸门和人工评审之间有多少次不一致。如果这个数字仍然明显高于零,就继续保持关闭。
还要一直记住一个警告:一套测试可能全部变绿,但它保护的产品仍然会崩溃,因为测试最终收敛到了测试本身,而不是产品规范。
绿色是证据,不是证明。
诚实地说,你构建的并不是对 Agent 的信任。
你构建的是一套足够紧的约束,让信任不再成为问题。
三句话,撑住这套纪律
只衡量 Agent 最终落脚的答案是不够的,还要衡量它走过的路径。
不会改变下一步运行方式的判定,只是一份报告。
任何没有被转化为永久测试的失败,之后都会再次遇到。
你账单上的模型名称,只是一项租赁费用。真正会被你留下的,只有围绕它工作的评判机制。
如果你想继续了解 Agent 内部机制,可以关注后续内容,也可以订阅 Telegram 频道: