
企业 IDC 部署大模型:从选型到上线
面向企业内网部署,比较 vLLM、SGLang、llama.cpp、Ollama 和 TensorRT-LLM,再按模型、显存、并发和采购预算给出一条可执行路径。
企业把大模型放进 IDC,真正难的不是把模型跑起来,而是回答五个问题:选哪套推理引擎?模型能解决什么业务问题?显存够不够?一台机器能扛多少并发?出了故障谁来处理?
这篇不讨论“最强模型”。我们只做一件事:给出一条从 PoC 到内网 API 的落地路径。
先给结论
- 大多数企业的第一套生产服务:Linux + NVIDIA GPU + vLLM + Qwen3-14B/32B 。
- 需要复杂结构化输出、批量请求或高并发优化:把 SGLang 纳入压测名单。
- 预算有限、单用户、边缘设备或 CPU 推理:llama.cpp 更合适。
- 给研发和业务快速验证:Ollama 上手最快,但不要直接把它当生产调度层。
- NVIDIA 数据中心卡、追求极限性能:再评估 TensorRT-LLM,前提是团队能承担更高的工程维护成本。
模型选择也不要从参数量开始。先看业务:知识问答、文档总结、代码助手、复杂推理,往往不是同一个模型最合适。
一套企业内网架构
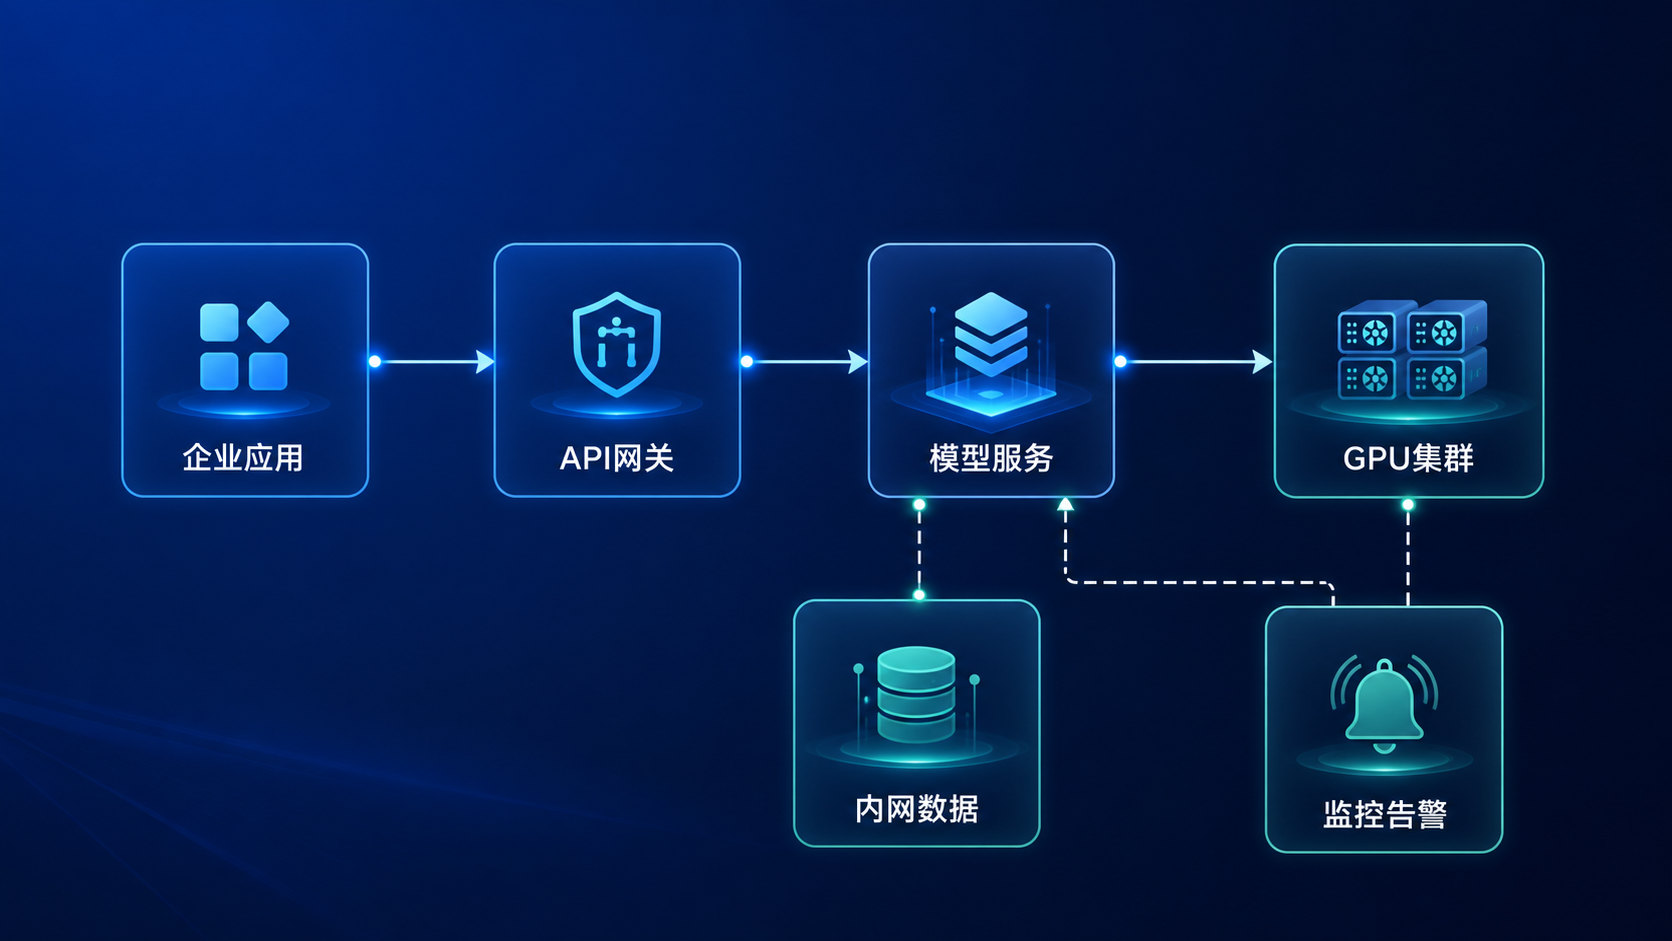
建议把模型服务放在独立的推理区,不要让每个业务系统直接访问 GPU 进程:
- 业务应用调用统一 API,不感知底层模型名称。
- API 网关负责鉴权、限流、审计和路由。
- 模型服务层负责 OpenAI 兼容接口、队列、超时和模型切换。
- GPU 集群运行一个或多个推理副本。
- 内网数据服务通过 RAG 接入,模型本身不需要吞下全部企业文档。
- 监控告警记录首 token 延迟、生成速度、并发数、显存占用和错误率。
IDC 部署的价值是数据不出内网,但“内网”不等于天然安全。模型服务仍要做访问控制,知识库也要按部门和角色切分权限。
推理工具怎么选
| 工具 | 定位 | API/接入 | 多 GPU 与量化 | 优点 | 短板 | 推荐场景 |
|---|---|---|---|---|---|---|
| vLLM | 生产级通用推理服务 | OpenAI 兼容接口 | 支持张量并行,常见 AWQ/GPTQ/FP8 路径 | 部署成熟,连续批处理,生态广 | 对 GPU 、 CUDA 和版本组合较敏感 | 企业聊天、知识库、内部 Copilot |
| SGLang | 高性能服务框架 | OpenAI 兼容生态 | 支持多 GPU 和结构化/复杂生成优化 | 适合高并发、复杂工作流压测 | 参数多,排障门槛高 | 高并发 API 、复杂 Agent |
| llama.cpp | 轻量本地推理 | llama-server 提供 API | GGUF,支持 CPU 、 GPU 和混合推理 | 硬件覆盖广,部署轻,边缘友好 | 多用户生产调度能力不如专用服务框架 | 边缘 IDC 、低并发、离线任务 |
| Ollama | 开发者友好的本地运行器 | REST API | 依赖底层运行时,模型管理方便 | 安装快,适合 PoC 和研发体验 | 缺少企业生产所需的完整调度、审计和高并发治理 | 试模型、演示、开发机 |
| TensorRT-LLM | NVIDIA 深度优化栈 | 需配套运行服务 | NVIDIA GPU 优化,支持量化和并行 | 有机会拿到更高性能和更低延迟 | NVIDIA 绑定更强,构建和升级复杂 | 已有 NVIDIA 平台、性能要求高的团队 |
实际建议:先用 vLLM 跑通业务接口,再用同一模型和同一数据集对比 SGLang 。不要拿不同模型、不同上下文长度、不同并发量的结果互相比较。
模型怎么选
下面的模型都是公开模型卡中能查到的候选,不代表它们在你的业务上已经验证通过。
| 模型 | 规模/上下文 | 强项 | 更适合解决的问题 | 代价与限制 | 建议部署 |
|---|---|---|---|---|---|
| Qwen3-14B | 14.8B;原生 32K,可用 YaRN 扩展到 131K | 支持思考与非思考模式切换,工具调用 | 企业知识问答、摘要、分类、客服初筛、轻量 Agent | 复杂推理和长上下文任务不如更大模型,扩展上下文会增加显存和延迟 | 单张 24GB 卡起步,生产建议保留 KV cache 余量 |
| Qwen3-32B | 32.8B;原生 32K,可用 YaRN 扩展到 131K | 更强的通用理解、代码和推理能力,同样支持两种模式 | 技术支持、合同/制度分析、复杂知识库问答、代码审查 | 显存和并发成本明显高于 14B | 48GB 卡或多卡量化 |
| DeepSeek-R1-Distill-Qwen-32B | 32B 级蒸馏推理模型 | 偏复杂推理、数学和多步分析 | 规则判断、方案拆解、复杂文档分析、离线批处理 | 推理输出可能更长,交互延迟和 token 成本更高;需要业务评测 | 48GB 级显存起步,低并发更合适 |
| Qwen3-Coder-30B-A3B-Instruct | 总参数 30.5B,激活参数 3.3B;原生 262K | 代码理解、工具调用、长仓库上下文 | 内部代码助手、 SQL/脚本生成、代码库问答、自动化工具编排 | 不是通用客服首选;长上下文会显著吃 KV cache | 以 48GB 卡压测为起点,必要时缩短到 32K |
按业务问题选模型
| 业务问题 | 首选起点 | 为什么 | 不要期待什么 |
|---|---|---|---|
| 企业制度、产品手册问答 | Qwen3-14B | 成本低,非思考模式响应快,配合 RAG 足够覆盖很多问答 | 不会自动解决权限、文档版本和引用准确性 |
| 技术支持和复杂故障分析 | Qwen3-32B | 更大的容量适合多段日志、规则和上下文组合 | 不能代替值班工程师确认生产变更 |
| 合同条款和规则判断 | Qwen3-32B 或 R1 Distill 32B | 可以让模型展开多步分析,再由规则或人工复核 | 不能把概率输出当成法律结论 |
| 代码助手和 SQL 生成 | Qwen3-Coder-30B-A3B-Instruct | 面向代码和工具调用,长上下文更适合仓库级输入 | 不会自动保证代码安全、正确或可直接上线 |
| 批量离线摘要和分类 | Qwen3-14B | 更容易通过批处理提高单位 GPU 产出 | 仍要处理格式错误、漏项和敏感信息 |
一个重要判断:企业知识问答通常优先投资文档清洗、权限过滤、检索和评测,不要一开始就把 14B 换成 70B 。模型变大只能缓解一部分理解问题,不能修复脏数据和错误权限。
硬件要求与预算
先记住一个粗略公式:
需要的显存 ≈ 模型权重 + KV Cache + CUDA/运行时余量
量化只压缩模型权重,不会消除上下文和并发带来的 KV Cache 。下面是以 Q4/Q5 量化、 4K 到 8K 上下文、少量并发为前提的起步估算。
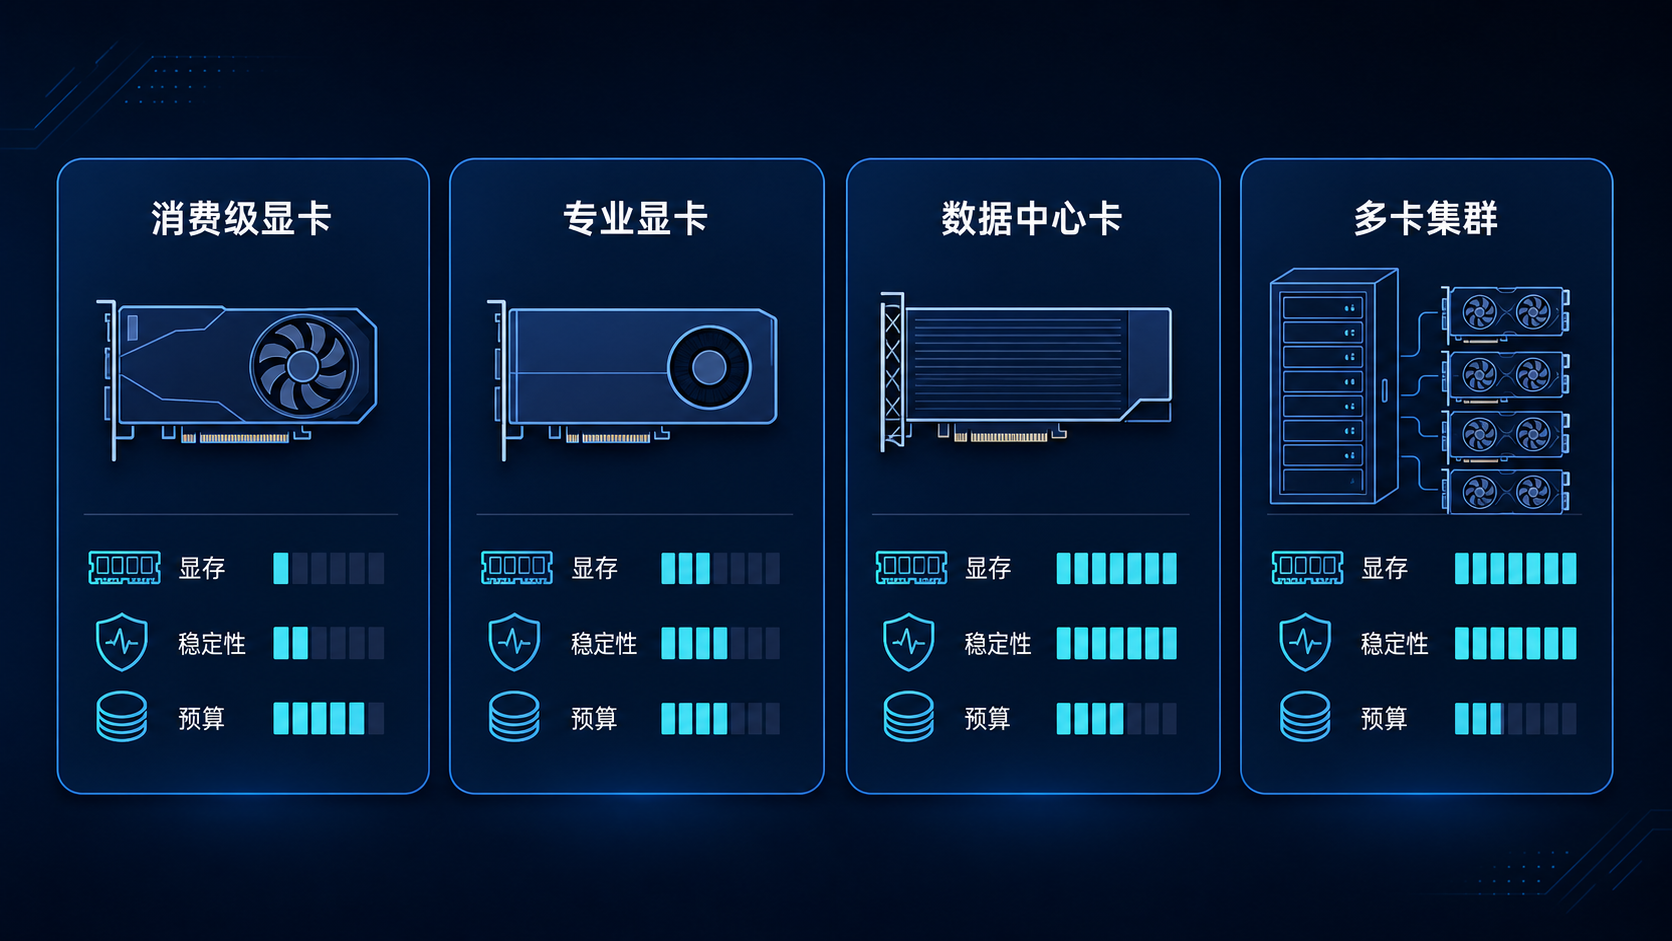
GPU 对比
| GPU 方案 | 显存 | 适合的模型 | 单卡/卡组采购预算估算 | 功耗与 IDC 注意事项 | 判断 |
|---|---|---|---|---|---|
| RTX 4090 | 24GB | 7B/14B Q4;部分 32B 需更激进量化 | 约 1.2 万–2 万元/卡 | 消费卡,散热、机箱、长时间稳定性和售后要单独设计 | PoC 和低并发性价比高 |
| RTX 5090 | 32GB | 14B Q4/Q5;部分 32B Q4 | 约 2 万–3.2 万元/卡 | 高功耗,需核对电源、槽位、风道和驱动支持 | 新建单卡节点的折中选择 |
| RTX 6000 Ada | 48GB | 14B/32B 量化;部分 70B 多卡 | 约 4 万–7 万元/卡 | 专业卡形态和显存更适合工作站/服务器,采购渠道差异大 | 企业单卡节点更稳妥 |
| L40S | 48GB | 32B 量化;多卡 70B | 约 7 万–12 万元/卡 | 数据中心卡,需考虑服务器认证、机架功耗和散热 | 正式 IDC 推理节点 |
| A100 80GB | 80GB | 32B 高质量、多并发;70B 量化 | 约 10 万–20 万元/卡 | 旧代平台但生态成熟,二手/渠道差异很大 | 已有存量平台或采购得到稳定货源 |
| 2×48GB / 4×48GB | 96GB / 192GB | 70B 量化、多并发 | 约 16 万–48 万元/卡组 | 需要核对 PCIe/NVLink 、 CPU 、内存、供电和机架规格 | 70B 或多租户服务 |
以上是中国大陆常见采购预算的粗估区间,不是厂商报价,未包含服务器、 CPU 、内存、 SSD 、网络、机柜、电力、税费和维保。正式采购必须用同一型号向集成商询价,并把连续运行、质保和备件写进合同。
三档落地预算
| 档位 | 推荐配置 | 能解决什么 | 预算粗估 |
|---|---|---|---|
| 验证档 | 1×24GB 或 1×32GB GPU,64–128GB 内存,1–2TB NVMe | 跑通 RAG 、摘要、分类、内部演示 | 约 2 万–5 万元整机 |
| 生产起步档 | 1×48GB 或 2×24GB,128–256GB 内存,2–4TB NVMe,冗余电源 | 14B/32B 量化 API,有限并发,单业务线使用 | 约 8 万–18 万元整机 |
| 稳定服务档 | 2×48GB 或 4×48GB,256GB 以上内存,系统盘与数据盘分离,监控和备件 | 32B/70B 量化、多业务路由、滚动维护 | 约 20 万–60 万元以上 |
预算不是性能承诺。真正上线前,必须用你的真实 prompt 、上下文长度、输出长度和并发模型做压测。
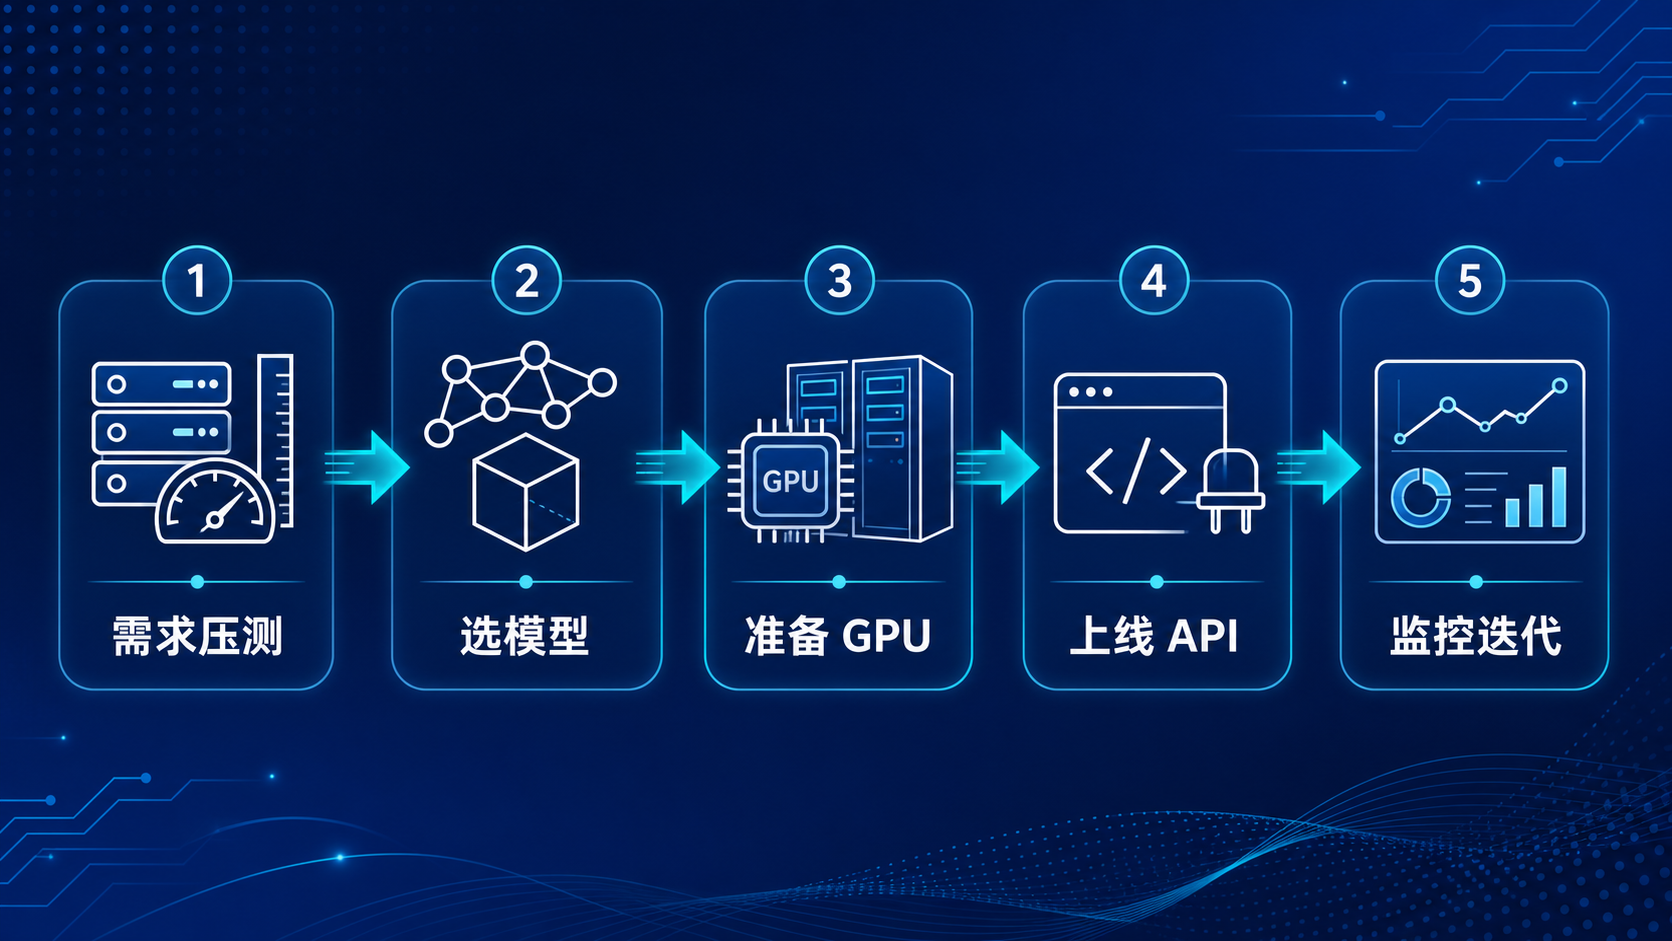
教程:用 vLLM 部署 Qwen3-14B API
下面这条路径的目标是:在一台 Linux + NVIDIA GPU 服务器上,把模型变成内网 OpenAI 兼容接口。示例假设已经安装 Docker 、 NVIDIA Container Toolkit,并能访问模型仓库。
1. 先做容量检查
nvidia-smi
free -h
df -h
确认显存、系统内存和模型缓存盘都够用。不要一上来就把 max-model-len 设成 131072,先按业务真实需要从 4096 或 8192 开始。
2. 启动服务
docker run --gpus all --name qwen3-14b \
  -p 8000:8000 \
  -v /data/models:/root/.cache/huggingface \
  --restart unless-stopped \
  vllm/vllm-openai:latest \
  --model Qwen/Qwen3-14B \
  --served-model-name qwen3-14b \
  --gpu-memory-utilization 0.90 \
  --max-model-len 8192 \
  --enable-prefix-caching \
  --host 0.0.0.0 \
  --port 8000
生产环境不要直接把 8000 暴露给办公网。前面放 API 网关或反向代理,至少加入身份认证、限流、请求日志脱敏和超时控制。
3. 发一个最小请求
curl http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -H 'Authorization: Bearer internal-test' \
  -d '{
    "model": "qwen3-14b",
    "messages": [
      {"role": "user", "content": "请用三句话说明企业内网部署大模型要先验证什么。"}
    ],
    "temperature": 0.2,
    "max_tokens": 256
  }'
如果接口返回正常,再接入业务系统。不要先接知识库、工作流、权限系统,最后才发现模型服务本身没有稳定运行。
4. 做一轮业务压测
至少记录这些指标:
| 指标 | 怎么看 | 失败信号 |
|---|---|---|
| 首 token 延迟 TTFT | 用户发起请求到第一个 token | 高峰期明显变慢 |
| 生成速度 | tokens/s | 长回答无法接受 |
| 并发稳定性 | 逐步增加并发请求 | 排队过长、超时、 OOM |
| 显存占用 | nvidia-smi 和服务指标 | 上下文一长就爆显存 |
| 输出质量 | 固定测试集人工/规则评分 | 格式错、引用错、答非所问 |
| 数据边界 | 审计请求和响应 | 敏感信息进日志或越权检索 |
压测要固定模型版本、量化方式、上下文长度、输出上限和 prompt 。否则“这个引擎更快”的结论没有意义。
5. 从单机走向生产
单机服务验证通过后,再补齐以下能力:
- 网关鉴权和按部门限流;
- Prometheus + Grafana 监控 GPU 、队列和延迟;
- 模型文件校验、版本登记和回滚目录;
- RAG 文档切分、权限过滤、引用展示和更新机制;
- 敏感词、个人信息和提示词注入防护;
- 灰度发布与故障切换;
- 用固定评测集持续比较模型升级前后效果。
如果要部署 32B 或更大模型,先在同一套 API 协议下替换模型,重新压测,再决定是否扩容 GPU 。不要为了“参数更大”直接重做整套业务架构。
最容易踩的坑
- 把模型权重大小当成显存需求。 KV Cache 、并发和运行时都会吃显存。
- 把 RAG 当成上传文件。 企业知识库首先是权限系统和文档治理问题。
- 把 Ollama 的顺滑体验当生产能力。 PoC 好用,不代表多租户、审计和故障切换已经解决。
- 把量化当成免费午餐。 Q4 能降低门槛,但要用业务测试集确认质量损失。
- 把模型回答当最终决策。 合同、财务、生产变更和安全告警都要保留人工或规则复核。
- 忽略模型许可证。 Qwen3-14B/32B 和 Qwen3-Coder-30B-A3B-Instruct 的模型卡标注 Apache-2.0;DeepSeek-R1-Distill-Qwen-32B 标注 MIT,但仍应保留上游许可和使用记录。
最终推荐
如果你今天开始做企业 IDC 大模型项目,我建议按这个顺序:
- 用 1×24GB 或 1×32GB GPU 跑 Qwen3-14B,先验证一个明确业务闭环;
- 用 vLLM 暴露统一 API,接入鉴权、日志脱敏和基础监控;
- 用真实数据集压测并记录 TTFT 、 tokens/s 、并发和质量;
- 只有当 14B 在业务评测中确实不够,再比较 Qwen3-32B 、 R1 Distill 32B 或 Coder 30B;
- 并发和延迟成为瓶颈后,再对比 SGLang 或 TensorRT-LLM;
- 把预算优先花在显存、散热、备件、监控和数据治理上,而不是只买更大的模型。
企业 IDC 部署的核心不是“把一个模型放进机房”,而是把模型变成一个有边界、可观测、能回滚的内部服务。
项目与文档: