
别让 Agent 排队:用动态工作流把复杂任务拆成一张图
多步 Agent 为什么越跑越慢?把任务拆成节点、边、并行、验证和汇总,Claude Code 的动态工作流给出了一套可复用的方法。
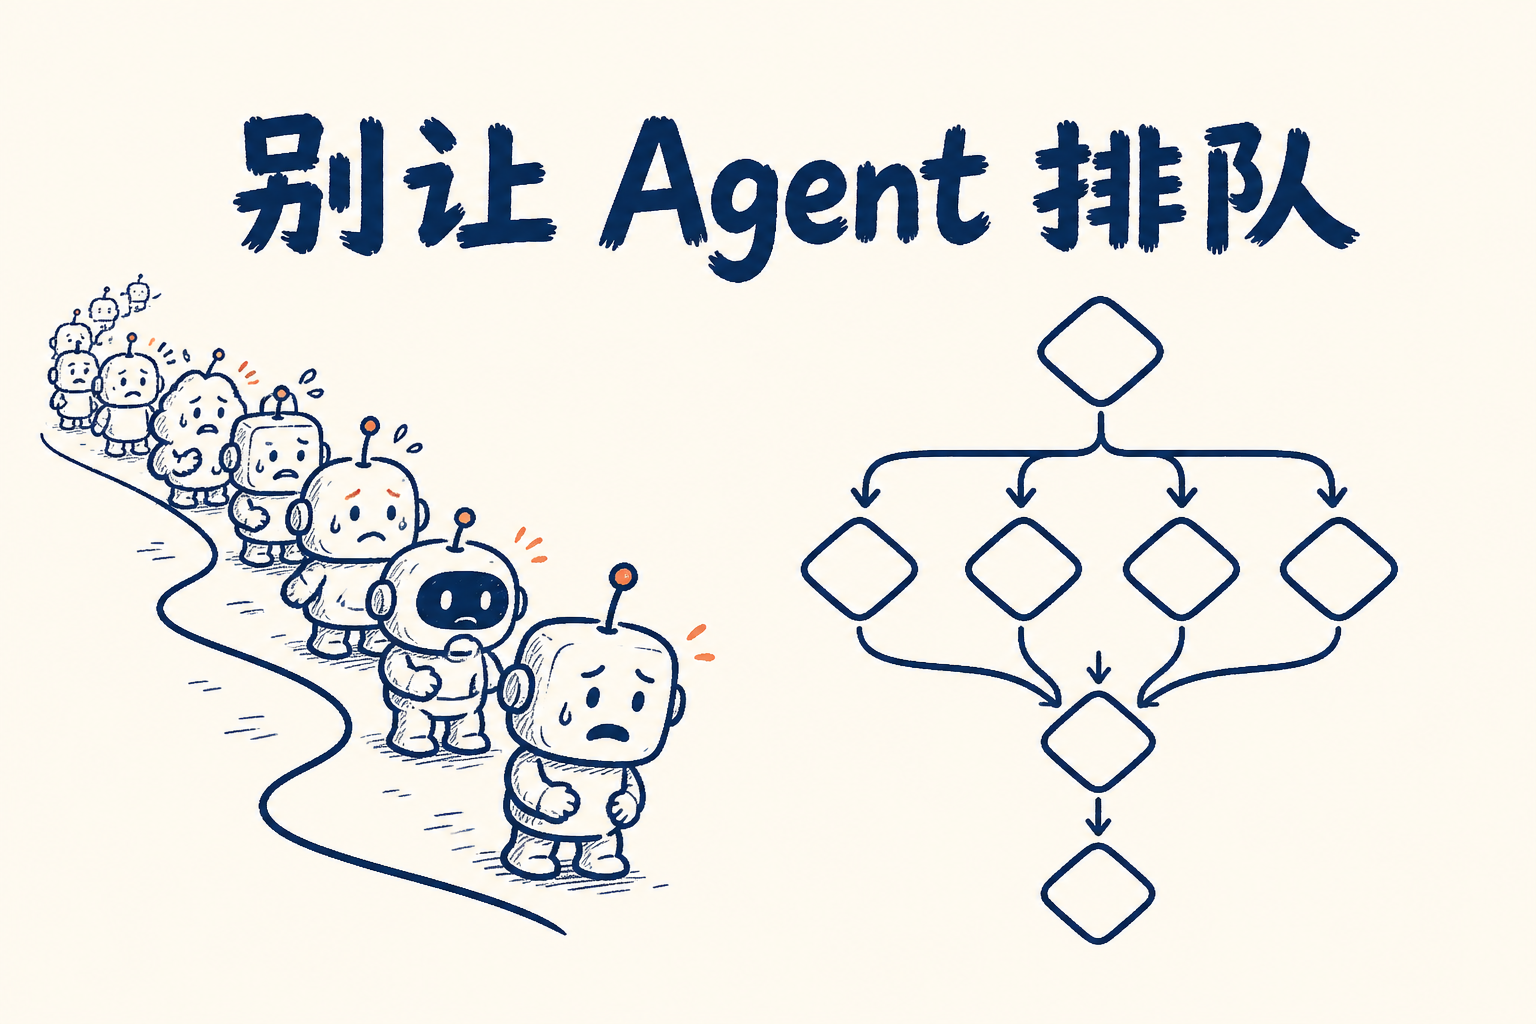
很多人搭 Agent,第一反应是把步骤一条条写下来:先找资料,再整理,再写报告。任务一复杂,这条线就会变长。前一步没结束,后一步不能开始;中间某个环节卡住,后面的工作全停。
这套写法能跑,但经常把本来可以同时做的事情排成了队。
Claude Code 最近的动态工作流,解决的就是这个问题。它让 Claude 先写一段 JavaScript 编排脚本,再由脚本批量启动子 Agent 。中间的任务分配、并行、汇总和重试由代码控制,主会话只接收最终结果。
对普通用户来说,可以把它理解成一句话:把一条 Agent 流水线改成一张任务图。
先搞懂“节点”和“边”
一张工作流图只有两个基本部件。
节点是一个明确的工作单元。比如读取一个文件、检查一个 API 、审查一个路由,或者把多份结果合成一份报告。每个节点最好有清楚的输入和输出。
边表示数据依赖。只有当后一个节点真的要读取前一个节点的结果时,二者才需要连接。
举个简单例子:“总结项目 README,然后检查天气”看起来有先后关系,但天气查询并不需要 README 摘要。它们是两个互不依赖的节点,放在一起排队只是浪费时间。
判断一条边是否必要,可以问一句:下一步真的要用上一步产出的数据吗?如果答案是否定的,这两个任务就有机会并行。
从直线改成菱形
复杂 Agent 最常见的一种结构是“菱形”:先拆分任务,再同时执行,最后汇总。
比如做一次代码审查:
- 找出所有需要检查的文件。
- 每个文件交给一个子 Agent 独立检查。
- 用代码过滤空结果、去重和整理格式。
- 让一个最终 Agent 汇总问题,并按严重程度排序。
这里的核心不是“多叫几个 Agent”,而是把不同类型的工作放到正确的位置。查文件、读代码、收集结果可以并行;跨文件去重和最终判断需要等结果齐全后再做。
Claude Code 官方把这种动态工作流定义为一段可以重复运行的 JavaScript 脚本。脚本变量负责保存中间结果,运行时负责调度子 Agent,主会话不会被每个中间结果塞满。
parallel() 负责同时做事
在动态工作流里,互不依赖的任务可以用 parallel() 批量启动。一个简化的结构大致是这样:
const results = await parallel(
  files.map((file) => () =>
    agent(`检查 ${file} 中的鉴权问题`, {
      schema: FINDING_SCHEMA,
    })
  )
);

const findings = results.filter(Boolean);
这段代码表达了四件事:每个文件是一个独立任务;任务同时运行;每个 Agent 按同一套格式返回;失败或空结果不会直接拖垮整批任务。
parallel() 会等这一批任务都结束后再返回,所以它天然带有一个“等待全部结果”的屏障。下一步如果需要看完整集合,就应该放在屏障之后。
但屏障也有成本。如果只是把数组摊平、去重或过滤,用普通 JavaScript 就够了,不需要再启动一个 Agent 。代码处理边与数据,模型处理判断和表达,这样更省 token,也更容易复现。
pipeline() 适合连续处理
并行和流水线解决的是两种不同的问题。
parallel() 适合“很多任务各自独立,最后一起收集”。例如检查 20 个文件。
pipeline() 适合“每个项目都要依次经过多个阶段,但项目之间可以错开”。例如每份文件都要经历读取、转换、校验三个阶段。文件 A 进入校验时,文件 B 可以还在转换,不必等 A 全部结束。
可以简单记成:需要整批结果时用屏障,需要让每个项目持续流动时用流水线。把所有东西都写成 parallel → 处理 → parallel,中间又没有跨项目依赖,通常说明屏障放多了。
给每个节点写清楚契约
一个节点如果输入输出都不稳定,就很难接进工作流。
建议至少明确三件事:
- 输入从哪里来,不能依赖一个不断膨胀的共享上下文。
- 输出是什么结构,能不能被下一个节点直接读取。
- 这个节点只做一件什么事,不能把检索、判断、改写全部混在一起。
Claude Code 的动态工作流支持给 Agent 声明 JSON Schema,让子 Agent 返回结构化数据。比如每个研究节点都返回标题、 URL 和影响等级,后面的汇总节点就能直接读取,不需要从一段自由文本里猜字段。
契约还让节点可以替换。只要输入输出形状不变,换模型、换提示词,甚至换成普通代码,都不必重画整张图。
验证要放在边上
多 Agent 不等于结果可靠。十个 Agent 同时犯同一个错误,最后只会得到一份更长的错误报告。
更稳的做法是在结果进入下一阶段前加验证节点。验证节点的任务不是把结果写得更漂亮,而是尝试推翻它:这条结论有证据吗?换一个角度还能成立吗?别人能复现吗?
常见的验证方式有三种:
- 让多个独立检查者专门寻找反例。
- 给不同验证者分配不同视角,例如正确性、安全性和可复现性。
- 先生成多个候选结果,再用并行评审选出更可靠的版本。
验证失败的结果不要继续流向最终答案。这样做会增加调用次数,却能把“看起来完成了”和“经得起检查”分开。
失败要被隔离,循环要能收敛
并行任务里,一个节点失败时,其他节点不应该全部作废。动态工作流可以把失败结果保留为空值,再由后续代码过滤,最后报告哪些任务没有完成。
文件并行修改时还要注意互相覆盖。官方文档建议用 worktree 让不同 Agent 在独立的 Git 工作树里工作,完成后再合并结果。
有些任务的规模一开始并不知道,比如持续寻找代码漏洞。这时可以做循环,但必须设置停止条件。一个实用规则是:连续两轮没有发现新问题,就停止。
去重时要对照“所有已经见过的结果”,不能只对照已经确认的问题。否则被否定的问题会在下一轮重新出现,循环也就停不下来。
动态工作流能做什么
Claude Code 官方文档把它定位在几类大任务上:
- 对整个代码库做相同类型的审计。
- 批量迁移大量文件,并逐个验证结果。
- 从多个来源研究同一个问题,再交叉核对结论。
- 对一个计划生成多个方案,再比较不同方案。
- 反复运行检查和修复,直到测试通过或连续几轮没有进展。
Claude Code 内置的 /deep-research 就是一种工作流,会把研究问题拆成多个搜索方向,抓取资料,交叉核对,再生成带引用的报告。用户也可以在提示词里直接要求使用 workflow,让 Claude 针对当前任务写一份编排脚本。
它不适合什么
小任务不需要工作流。改一个拼写、查一个文件、修一个简单报错,直接让单个 Agent 做更快。
动态工作流也不是“零成本并发”。每个子 Agent 都会消耗 token,运行数量越多,费用和排查难度越高。官方文档明确提醒,工作流适合几十到数百个 Agent 的大任务,但也提供了并发和总量上限来避免无限膨胀。
另外,工作流脚本只能负责编排,不能直接代替 Agent 访问文件系统或执行 Shell 。真正的读写和命令执行仍由子 Agent 完成。长任务开始前,要先确认权限、模型额度、网络访问和可验证的停止条件。
动态工作流要求 Claude Code v2.1.154 或更高版本。具体可用范围还取决于账号方案、模型提供方和当前版本配置。官方文档入口是 动态工作流,并行方式对比见 Run agents in parallel。
如果你发现自己的 Agent 总在“先做 A,再做 B,再做 C”,下一步可以先画图,不急着加提示词。把真正的数据依赖画出来,把能同时做的任务放到同一层,再把验证和汇总放在需要等待的位置。很多慢问题,起点只是把本来可以并行的工作写成了一条直线。