
让 DeepSeek 看懂图片:一个插件把视觉能力接进 CLIProxyAPI
DeepSeek 本身只处理文字?这个原生插件先让视觉模型读图,再把分析结果交给 DeepSeek,兼容三种请求协议。
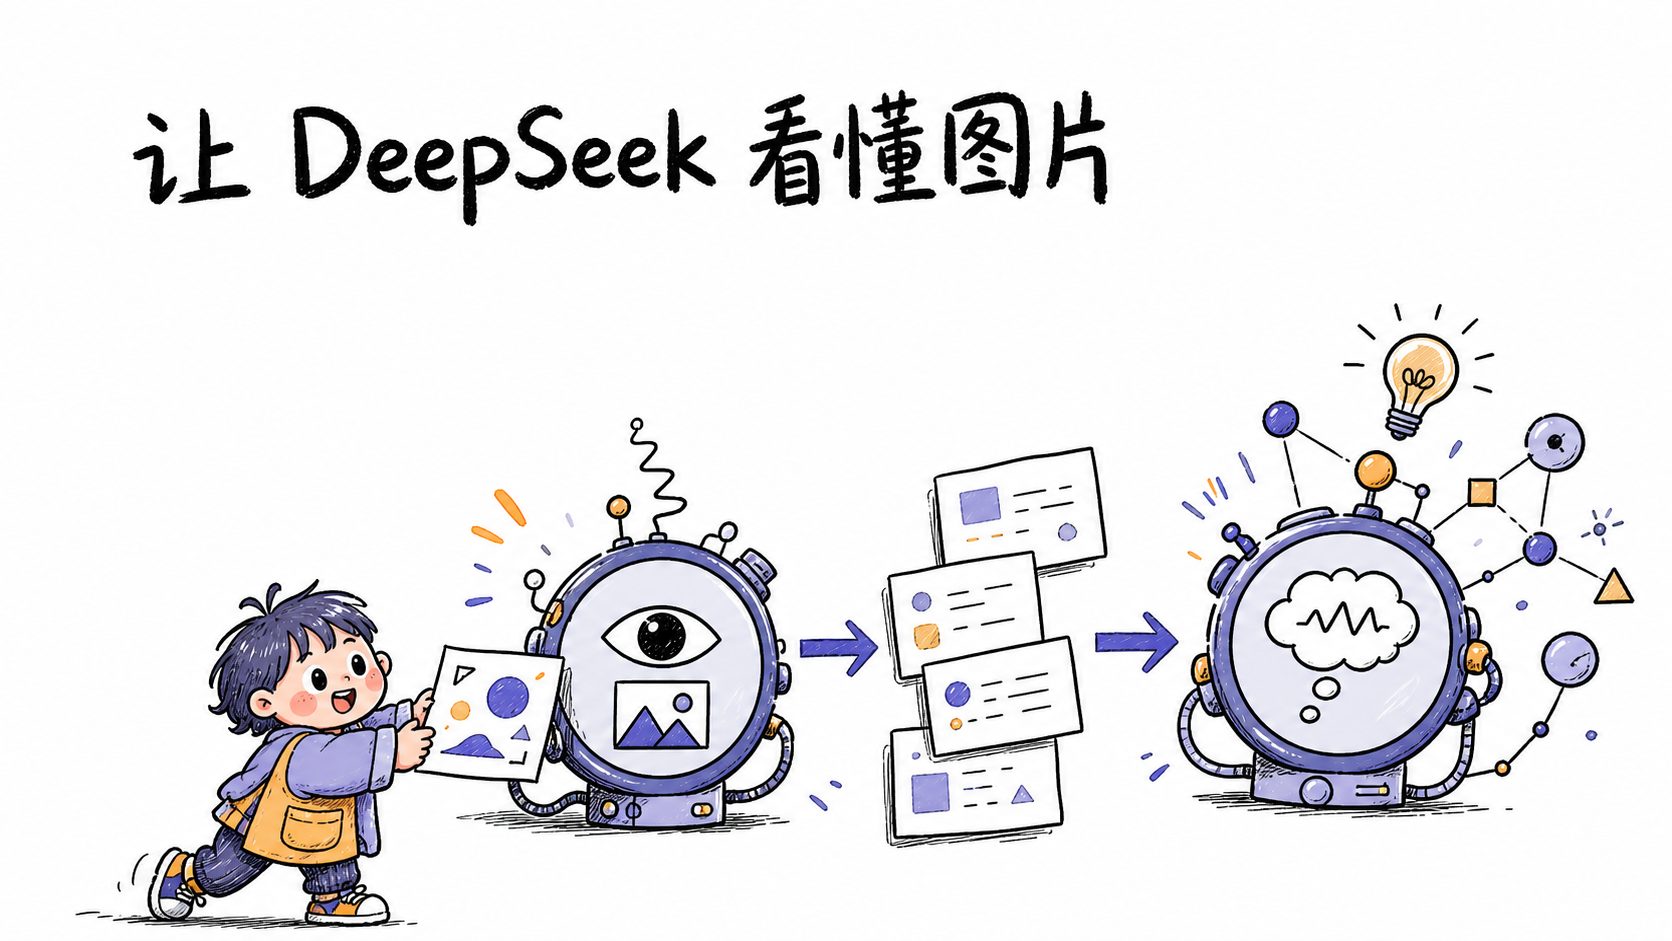
很多人用 DeepSeek 做代码排障时,会卡在一个很具体的问题:截图、流程图和页面录屏截帧发过去了,文本模型却无法直接读取图片。
deepseek-vision 给 CLIProxyAPI 加了一层原生请求预处理。视觉模型先看图,把图片转换成文字分析;DeepSeek 接着拿着这份分析继续推理。原图不会被继续转发给它。
这条路线适合已经在用 CLIProxyAPI 、又想把图片理解能力接到 DeepSeek 上的人。它不需要新增代理地址,也不需要额外配置一套 API Key 。模型路由、凭据、协议转换、重试和供应商限流,仍由 CLIProxyAPI 负责。
它具体做了什么
插件当前面向 CLIProxyAPI v7,默认目标模型是 deepseek-v4-flash。它会在命中指定路由和目标模型后,扫描请求里的图片,把同一条 prompt 中的多张图片合并分析,再把视觉结果写回请求。
支持的入口包括:
- OpenAI Responses:
/v1/responses - OpenAI Chat Completions:
/v1/chat/completions - Anthropic Messages:
/v1/messages
图片可以来自 URL 或 data URI 。多图会保留顺序和相互关系,适合比较多张截图、分析页面改版,或者把历史图片和当前问题放在一起看。
插件还提供了受控的二次分析。第一次只让视觉模型描述页面结构,下一轮可以针对字体、颜色或某个按钮重新提问。这个能力默认关闭,只有配置 agent_reanalysis_enabled: true,并且请求明确声明 view_image 或对应 rich tool output 时才会启用。
请求是怎么走的
大致流程可以理解为:
- CLIProxyAPI 先完成鉴权、别名和最终模型解析。
- 插件确认协议、路径和目标模型都命中支持范围。
- 插件按 prompt 分组,调用视觉模型分析图片。
- 分析成功后,插件检查请求里不再包含图片块。
- DeepSeek 使用图片分析和原始问题继续回答。
同一条 prompt 里的多张图片通常只进行一次联合视觉分析。普通分析结果可以走进程内缓存;专项重分析支持 refresh 和 no_store 两种语义。
怎么安装
最省事的办法是打开 CLIProxyAPI 的 Management HTML,进入插件商店,搜索 DeepSeek Vision,然后安装并启用它。插件商店负责索引和分发,代码与 Release 仍由项目仓库维护,安装前要确认来源和权限。
也可以从项目的 Release 下载与运行平台匹配的 v0.3.0 压缩包。解压后是一个动态库,放进 CLIProxyAPI 的插件目录:
plugins/<GOOS>/<GOARCH>/deepseek-vision.<ext>
Linux amd64 使用 plugins/linux/amd64/deepseek-vision.so,macOS 使用 .dylib,Windows 使用 .dll。 Docker 部署时,按容器架构选择 Linux 资产,并把宿主目录映射到容器内的 /CLIProxyAPI/plugins。安装后重启服务,再在 Management HTML 的插件页面启用 deepseek-vision。
最小配置可以写成:
plugins:
  enabled: true
  configs:
    deepseek-vision:
      enabled: true
      vision_model: gpt-5.6-luna
vision_model 必须是 CLIProxyAPI 中已经可用的视觉模型。需要备用模型时,可以填写 vision_fallback_models,最多配置 3 个,路由和凭据依旧由宿主管理。
能做什么,不能做什么
它适合处理网页截图、代码截图、表格、按钮布局和多图对比,也能把图片分析结果带入后续的 DeepSeek 对话。官方仓库给出的测试记录显示,在特定任务导向提示和低推理视觉请求下,视觉阶段耗时曾从 27.8 秒降到 7.4 秒、从 49.1 秒降到 16.6 秒。这是项目自己的 A/B 测试记录,不能直接当成所有部署环境的性能承诺。
它目前有几条边界:
- 预处理必须在响应流开始前完成,首字节时间会增加。
- 只改写精确命中的三类协议和目标模型,其他请求会旁路处理。
- 只有文件 ID 、没有图片 URL 或 data URI 的请求会返回 422 。
previous_response_id隐藏的服务端历史不在插件可见范围内。- 缓存只存在单个进程里,多实例之间不会共享。
- v0.3.0 发布了 Linux 、 macOS 、 Windows 的 amd64 和 arm64 资产,FreeBSD amd64 还没有经过该版本的实机验收。
deepseek-v4-pro不是 v0.3.0 的发布验收目标,需要自行加入目标列表并验证上游 Responses 是否可用。
还有一个实际成本:视觉模型需要读取图片,图片 URL 也可能由上游视觉模型所在的网络访问。部署时要检查 DNS 、网络出口和 allowlist,不要把敏感截图随便交给不熟悉的上游服务。
适合谁
如果你已经有 CLIProxyAPI,平时用 DeepSeek 处理代码、网页或多轮上下文,只是缺少图片输入,这个插件值得试。它复用了宿主已有的鉴权和模型路由,迁移成本相对低。
如果你还没有 CLIProxyAPI,只是偶尔想让 DeepSeek 看一张图,单独搭这套链路可能有点重。先确认自己是否真的需要多模型路由、协议兼容和插件化管理,再决定要不要部署。
项目采用 MIT License,代码和安装文档都在 GitHub 仓库:
如果你的工作流里已经有“截图交给视觉模型,文本模型继续分析”这一步,这个插件做的事情很明确:把这段中间过程放进 CLIProxyAPI 里,并尽量保持原来的客户端和调用方式不变。