
DeepSeek V4 Pro 0813 正式版发布,部分测试超过 Fable 5
DeepSeek V4 Pro 0813 正式版发布。按公开对比表,部分测试项目超过 Fable 5,但这仍是单张基准表,不能等同于全面领先。
DeepSeek V4 Pro 0813 正式版发布。
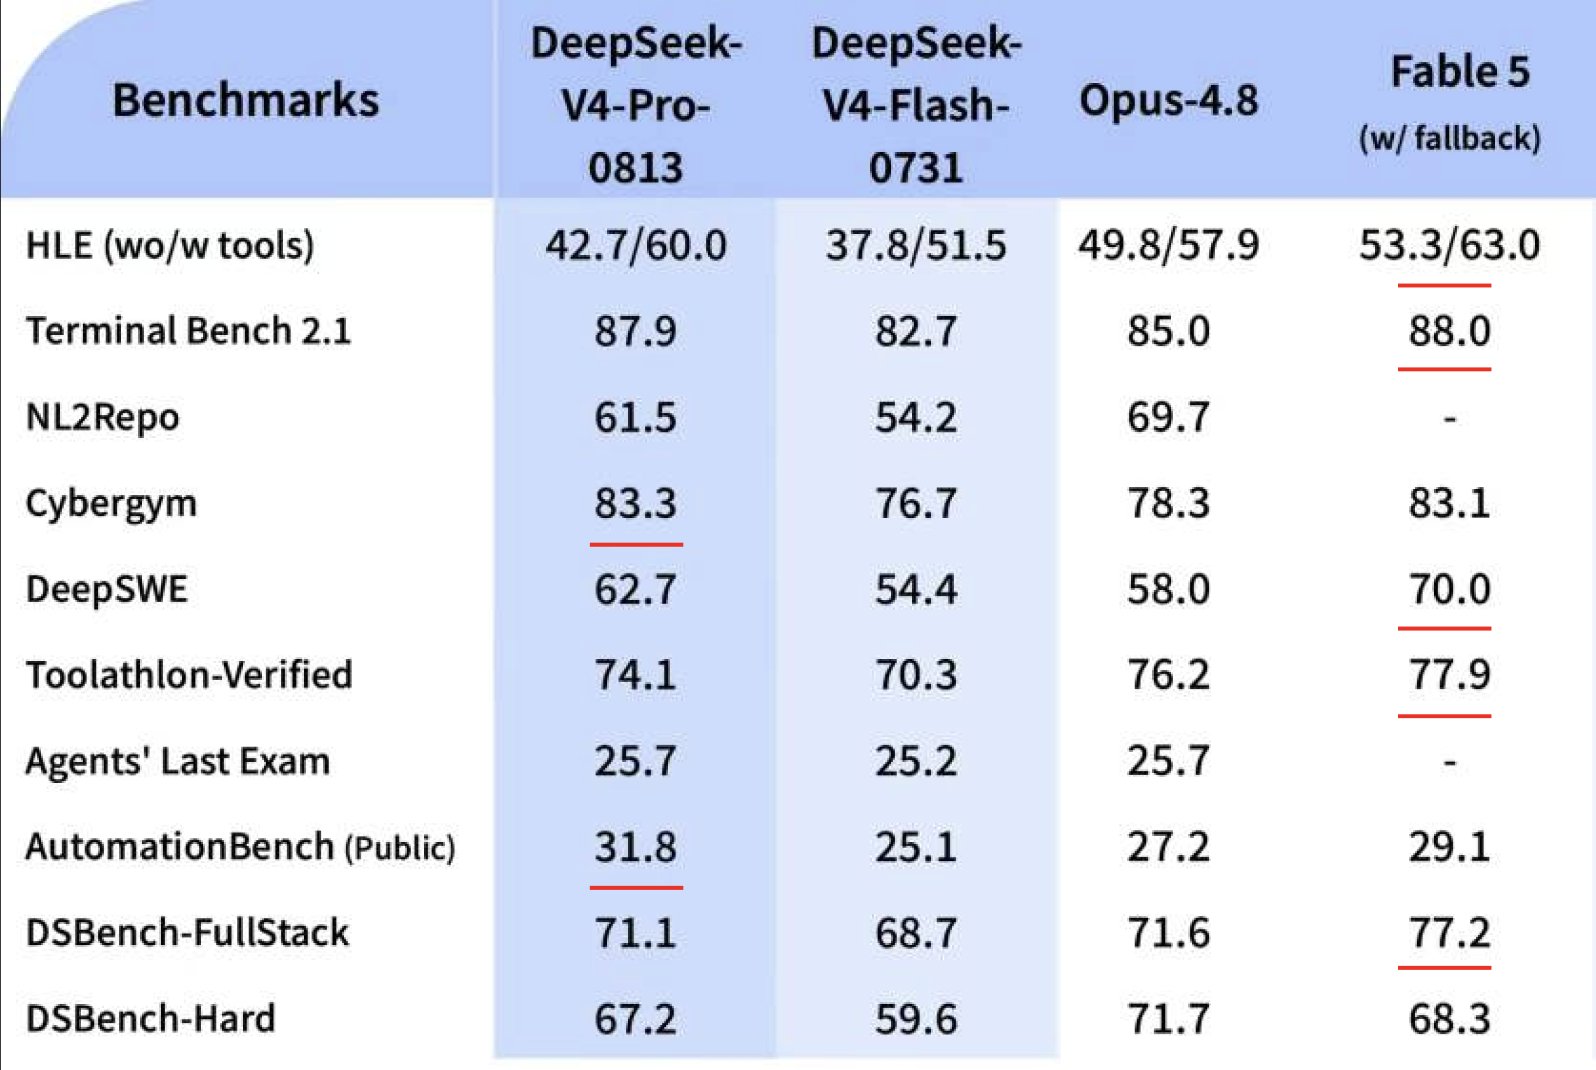
根据目前流传的公开对比表,V4 Pro 在部分测试项目上超过 Fable 5,也有多项成绩高于 Opus 4.8 。表格显示,DeepSeek V4 Pro 0813 在 Cybergym 、 DeepSWE 、 AutomationBench(Public)等项目中拿到较高成绩,但在 HLE 、 Terminal Bench 2.1 、 DeepSWE 、 Toolathlon-Verified 和 DSBench-FullStack 等项目上,Fable 5 仍然领先。
换句话说,这次发布的看点不是“全面超过所有模型”,而是国产模型在复杂代码、工具调用和自动化任务上的对比成绩继续往前走。
目前能确认什么
- DeepSeek V4 Pro 0813 已有正式版发布信息流传;
- 对比表包含 HLE 、 Terminal Bench 2.1 、 NL2Repo 、 Cybergym 、 DeepSWE 、 Toolathlon-Verified 、 Agents’ Last Exam 、 AutomationBench 、 DSBench 等项目;
- V4 Pro 在部分项目中超过 Fable 5;
- Fable 5 依然在多项测试中保持优势;
- 公开信息还不足以证明 V4 Pro 在所有任务、所有成本和所有实际工作流中都全面领先。
价格可能是更大的变量
这条消息里另一个值得注意的点,是价格差异。
相关分享将 DeepSeek V4 Pro 与 Fable 5 的价格差距描述为约 100 倍。不过,这个数字需要结合具体 API 版本、输入输出 Token 价格、缓存策略、上下文长度和计费方式确认,不能只看一个简单倍数。
如果性能接近,价格差距就会直接影响开发者的选择:
- 个人开发者会更在意调用成本;
- 企业会比较稳定性、限流、数据处理和服务协议;
- Agent 产品会关注长任务中的失败率和重试成本;
- 编程工作流会关注代码修改是否可验证,而不只是单次榜单成绩。
对于模型用户来说,真正需要观察的是“效果、价格、稳定性”三项能不能同时成立。
还需要继续观察
目前这张表更适合作为发布快讯和后续测试线索,不宜直接当成完整评测。后续还需要看:
- 官方模型页面和 API 是否同步更新;
- 各项基准的测试设置是否一致;
- 是否包含工具、 Fallback 或特殊提示词;
- 同一模型多次运行时的成绩稳定性;
- 实际代码任务中的成功率、延迟和重试次数;
- 正式价格和服务限制是否发生变化。
短期看,DeepSeek V4 Pro 0813 的发布会增加国产模型在代码和 Agent 场景中的竞争力。长期能不能改变开发者的默认选择,还要看真实项目里的成本和稳定性。