
AI 提示词该删了:一套 4 层上下文审计法
Anthropic 据称删掉 Claude Code 系统提示词中超过 80% 的内容。问题可能不在提示词太短,而在长期积累的指令、记忆、文件和工具已经互相冲突。
上下文工程的规则变了:该删掉什么
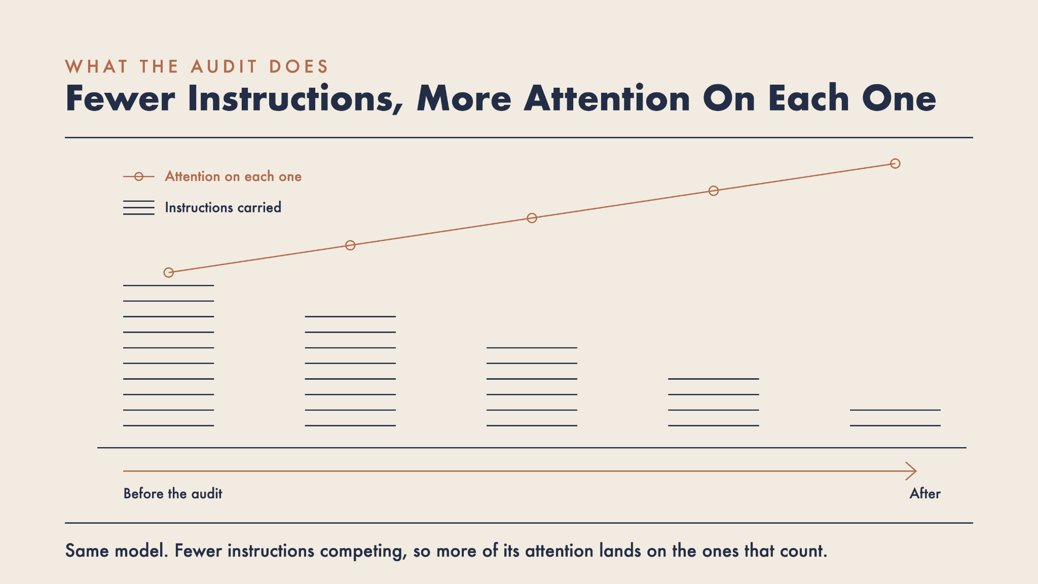
Anthropic 删除了自家 AI 指令的 80% 。 什么也没坏。
你为 AI 项目写下的指令,很可能也背负着同样的冗余,而这份指南就是帮你把它们清理掉的审计方法。
Anthropic 删除了自家 AI 指令的 80% 。
什么也没坏。
Anthropic 工程师 Thariq Shihipar 刚刚分享了公司为最新模型进行构建时得到的经验。
他们移除了 Claude Code 系统提示词中超过 80% 的内容,在代码评测中却没有测出任何损失。
如果 Anthropic 自己的指令里都存在这么多冗余,你的指令大概率也一样。不是因为你写得不好,而是因为这些指令原本是为一个后来已经被替换的模型写的。
其中一个发现比其他发现都更重要:过了某个临界点,继续增加上下文不再有帮助,反而会开始造成伤害。
知道该删掉什么,本身就是一项值得掌握的能力。
这套审计方法适用于任何带有指令输入框、记忆设置或文件上传功能的助手。不需要写代码。
内容包括
→ 为什么你的指令正在变得过时,以及三个独立团队发现了什么
→ 今天就能运行的「四层上下文审计」框架
→ 「删除测试」:针对每条指令的四个问题
→ 4 个可以直接复制粘贴、替你运行审计的提示词
→ 最常见的几类错误
→ 这套审计不适用的场景
为什么你的指令正在变得过时
上下文工程,指的是管理模型在你的提示词之外所能看到的一切内容。
你的长期指令、助手对你的记忆、上传的文件,以及它能够调用的工具,如今都是你在不更换工具的前提下,能够控制的、影响输出质量最大的几个杠杆。
Shopify CEO Tobi Lütke 最早将其描述为:为任务提供所有必要上下文,让大型语言模型有可能解决这个任务。几天后,Andrej Karpathy 也认可并推动了这个说法。
Anthropic 在 2025 年 9 月正式提出了「上下文工程」这一概念。
不到一年后,他们却删掉了自己提供的大部分上下文。
他们用来描述这次删减的词是「解除束缚」(unhobbling)。这些约束原本是为了阻止旧模型做出愚蠢的行为。
新模型的判断力更强了,于是这些约束不再起到保护作用。它们现在只是模型在开始处理真正任务之前,必须先绕开的指令。
Anthropic 在自己的对话记录中发现了这一点。
其中一条规则说,在适当情况下留下文档;另一条规则又说不要添加注释。
两条规则出现在同一个请求里。模型必须先解决这个冲突,才能开始工作。
你的设置里几乎肯定也存在类似问题:不同月份添加的内容,正在悄悄地彼此争论。
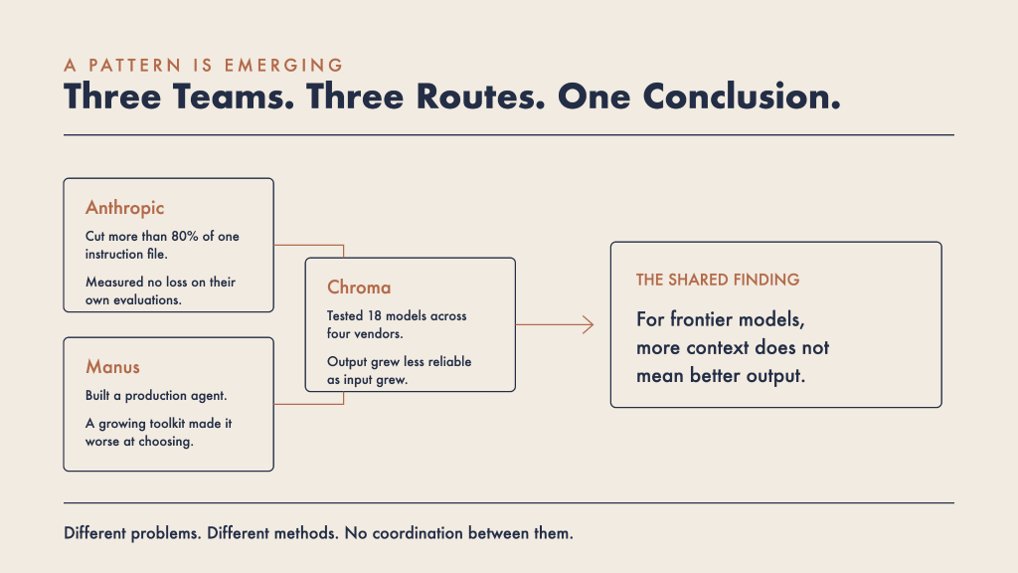
他们也不是唯一得出这个结论的人。一个共同的模式正在浮现,三个独立团队从不同方向走到了同一个结果。
Chroma 测量了底层行为。在 2025 年 7 月 14 日发表的研究中,Kelly Hong 、 Anton Troynikov 和 Jeff Huber 测试了 Anthropic 、 OpenAI 、 Google 和阿里巴巴旗下的 18 个大型语言模型。
他们发现,不同模型使用上下文的方式并不相同,而且随着输入长度增加,模型表现越来越不稳定。
Manus 则是在工具层面构建生产级 Agent 时撞上了同一堵墙。他们不断扩大的工具箱,并没有让 Agent 更有能力,反而让它更难做出正确选择。
问题各不相同,结论却一致:对于前沿模型来说,更多上下文并不意味着更好的输出。
这也引出了一个经常被忽略的部分。
上下文窗口在扩大到超过一百万个 token 的同时,最佳实践却变成了尽量少用上下文。
最大的限制因素是注意力。
四层上下文审计
Anthropic 发布了他们如今构建上下文时遵循的六个变化。下面这套审计,针对其中与现有指令相关的三个变化展开。
大多数人只审计四层中的一层,这就是为什么单独清理指令通常很难解决问题。
这四层按照「你能看到它们的程度」排列。第 1 层是你亲自写下的文件,第 4 层则是屏幕上完全不会告诉你的那一层。
第 1 层:长期指令
它是什么:每一次请求都会一同发送出去的文字。
包括 ChatGPT 的自定义指令、 Claude 的项目指令、任何 API 工具里的系统提示词、 CLAUDE.md 文件,以及自定义 GPT 或 Gem 中的指令字段。
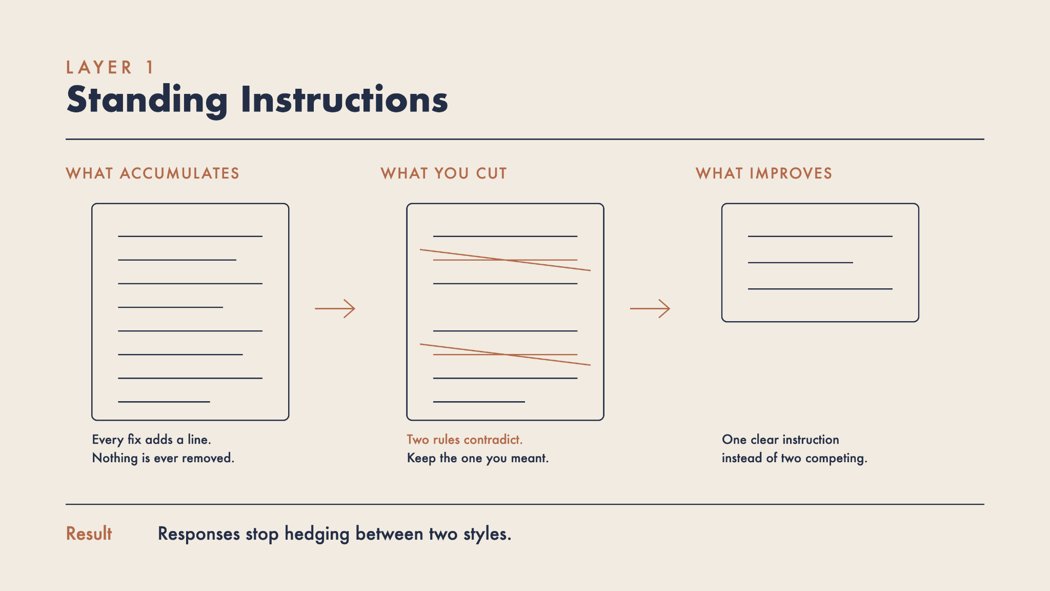
为什么问题会越来越严重:这一层只会不断增长。
助手做了一件让人恼火的事,你就加一行规则来阻止它,而这行规则会永远留在那里。没有人会定期打开文件,把已经不需要的内容删掉。
一年里不断追加的小修正,最后会形成一份自相矛盾的文档。
该删什么:
→ 告诉模型要有帮助、准确、全面或专业的指令,因为这些描述的是模型的默认行为
→ 只在某种你已经不再遇到的场景中才会触发的规则
→ 任何两条相互矛盾的规则中,其中你实际上并不想要的那一条
该保留什么:具体而出人意料的内容。
你的团队把客户对象称为 Account,尽管数据库表叫 users 。你需要使用 ISO 格式的日期,因为财务系统会拒绝其他格式。
Anthropic 自己的建议是:把文字用在工作中那些具体的陷阱上,而不是用来描述模型通过观察就能推断出的显而易见事实。
清理之后你会注意到:助手不再在两种风格之间犹豫。
因为它只需要遵循一条指令,而不是在两条互相竞争的指令之间做选择,所以回答会更加果断。
第 2 层:记忆
它是什么:助手在不同会话之间自动保存的、关于你的信息,即使你没有主动要求它保存。
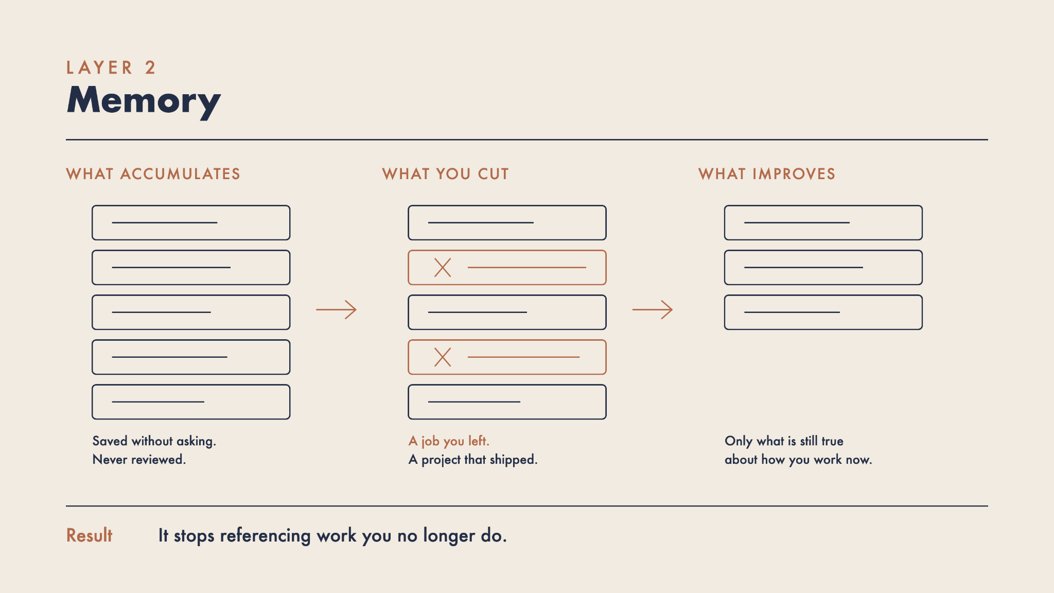
为什么问题会越来越严重:这些内容不是你亲自写的,所以你也不会主动检查。它会在后台不断积累,并进入你的每一次对话。
在哪里找到它:
→ Claude:进入 Settings,然后选择 Capabilities,再进入 Memory 。条目按类别分组,每一条都可以单独编辑或删除。
→ ChatGPT:进入 Settings,然后选择 Personalization,再进入 Manage memories 。每条已保存的信息都有自己的删除控件。
该删什么:
→ 来自你已经离开的工作、已经上线的项目,或已经停止使用的工具的信息
→ 你已经改变的偏好
→ 几乎表达同一件事的重复条目
清理之后你会注意到:助手不再提起那些你已经不再做的工作。
过时的记忆比没有记忆更糟,因为模型会把它当成当前信息。
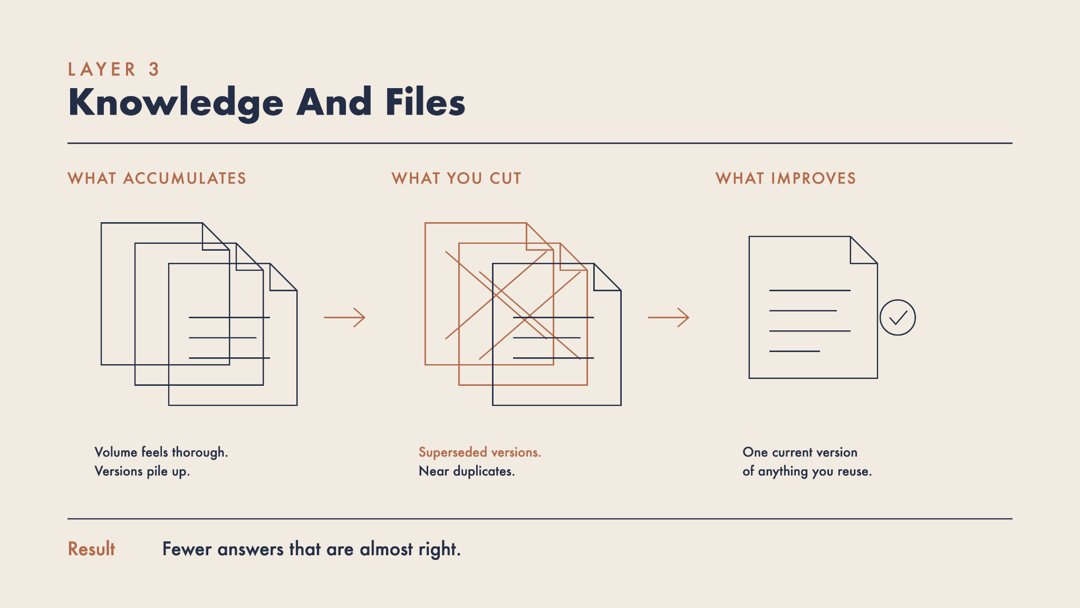
第 3 层:知识与文件
它是什么:上传的文档、已连接的云盘、项目知识库,以及检索系统会搜索的参考资料。
为什么问题会越来越严重:在这一层,文件数量很容易让人产生「越多越全面」的感觉。
十份文档看起来比两份更严谨,于是没人删除任何东西,不同版本就这样并排堆在一起。
该删什么:
→ 首先删除已经被取代的版本。因为如果六月草稿和最终版本同时存在于同一个项目中,模型没有可靠办法知道你指的是哪一份
→ 几个月前为某一个问题上传、如今已经不再需要的文档
→ 只相差一段文字的近似重复文档
第一项代价最大。模型有时会自信满满地根据过时版本回答。
该保留什么:你会反复引用的资料的当前版本。
如果一个项目需要大量参考资料,就按主题拆成多份独立文档,而不是放进一个超长文件。这样,助手只会在具体任务中调取所需内容,这正是这套审计方法本身所遵循的原则。
清理之后你会注意到:回答「差不多对、但并不完全正确」的情况变少了。
大多数检索失败,原因不是系统推理得不好,而是找错了文档。这也是这一层最容易带来明显质量提升的原因。
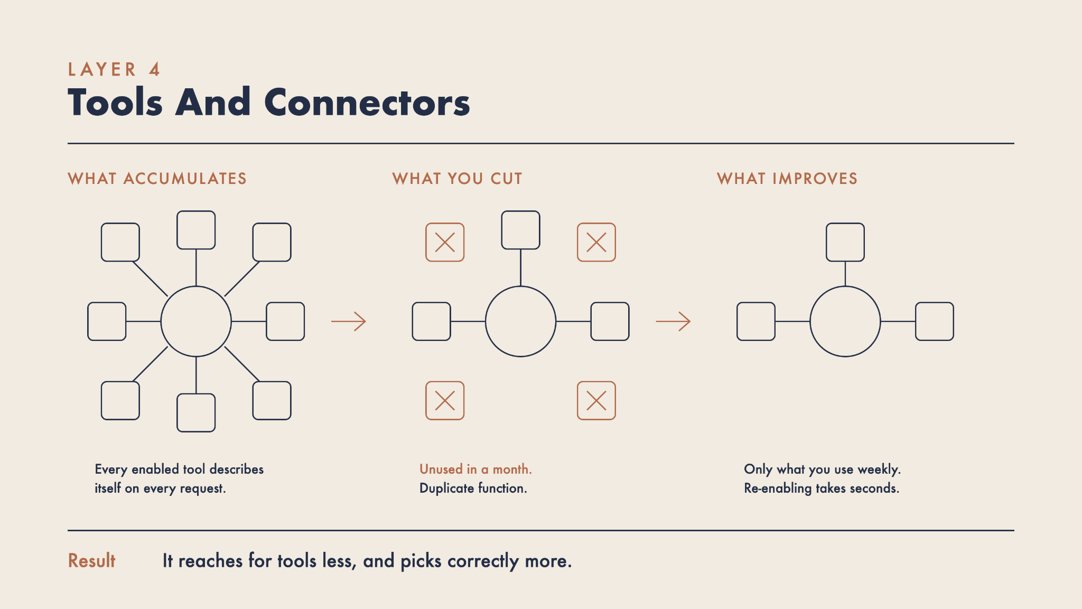
第 4 层:工具与连接器
它是什么:所有能让助手采取行动、而不只是回答问题的东西。
包括连接器和集成、自定义 GPT Actions 、插件、 Claude skills 、 MCP 服务器,以及任何你点击启用过的功能。
为什么问题会越来越严重:启用工具只需要点击一下,却没有任何机制提醒你定期检查。人们积累连接器的方式,就像积累浏览器扩展一样。
为什么它的成本高于其他层:每个启用的工具都会在每次请求中向模型描述自身,即使你还没有提出任何任务。
十个未使用的连接器,意味着每次对话都有十段工具描述在争夺模型的注意力。
这一层的成本之所以隐蔽,是因为屏幕上没有任何东西会告诉你它正在发生。
它造成的失败:Manus 作为一款完整的 Agent 产品,发现不断增长的工具箱会降低性能。
模型会在本该直接回答时调用工具,或者在两个功能相近的工具之间做出错误选择。
如果你的助手开始对那些仅凭已有知识就能回答的问题进行搜索,这一层很可能就是原因。
该删什么:
→ 你过去一个月没有使用过的任何工具
→ 两个完成相同工作的工具中的一个,保留你更信任的那个
重新启用只需要几秒钟,所以删除它几乎没有成本。
该保留什么:每周都会使用的工具,以及工作流程所依赖的工具。
清理之后你会注意到:助手调用工具的次数减少了,而且更经常选择正确的工具。
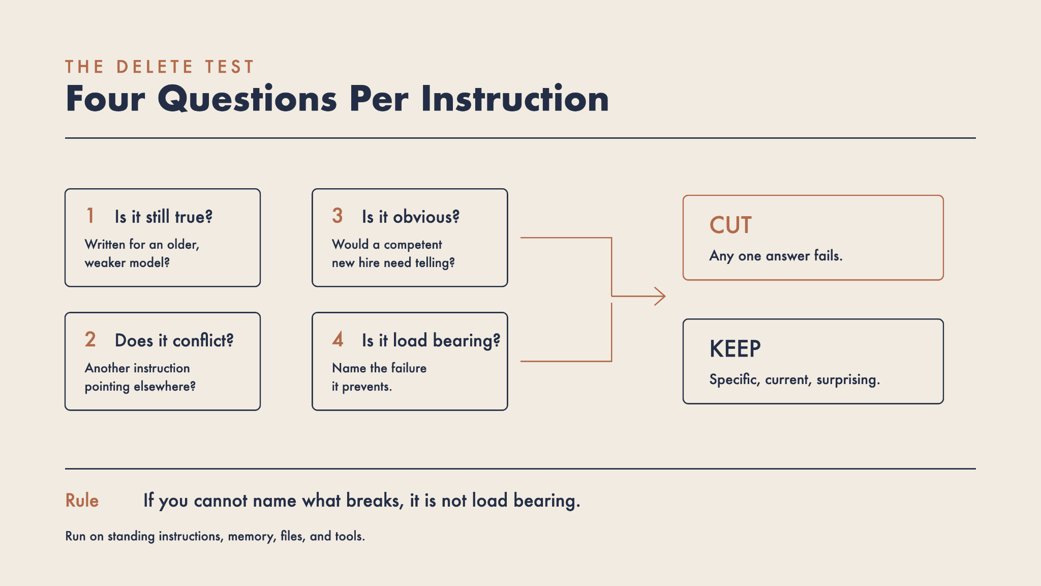
删除测试
冗余不会安静地待在那里。它会表现为含糊其辞的回答、错误的工具选择,以及被部分忽略的指令。
目前,长度还不是你的主要问题。相关研究是在数万 token 的规模上测到性能下降的,远远超过指令输入框里的内容长度。
今天的问题是冲突。两条指向不同方向的规则,无论总长度是多少,都会让模型额外消耗推理工作。这也是 Anthropic 举的例子关注矛盾,而不是字数的原因。
所以,针对每一条指令,问自己四个问题。
- 它现在还成立吗?
这是为更旧或更弱的模型写的吗?其中是否提到了一个已经发生变化的版本、限制或能力?
- 它和其他内容冲突吗?
四层中的任何一层里,是否有另一条指令指向不同的方向?
冲突成本最高,因为模型必须先解决冲突,才能开始处理你的工作。
- 一个能力合格的新员工需要被告知这件事吗?
如果一个有能力加入团队的人本来就应该知道,那么模型也知道。这会是你最快删掉的一类内容。
- 删除它之后,什么会出问题?
说出它具体阻止了哪一种失败。如果你说不出来,它就不是承重结构。
四个问题中,只要有一个答案指向删除,就可以删。保留具体、当前且出人意料的内容。
其中有两类内容需要用不同方式处理,在开始删除之前值得先说明。
显而易见的指令和已经失效的冲突可以立即删除,因为你能直接在页面上看出问题。至于你怀疑是过时的临时补丁的内容,先移除一周;如果质量下降,再恢复它。
用 4 个提示词替你运行审计
下面 4 个提示词可以端到端地运行这套审计。
第一个找出冲突。第二个区分真实偏好与过时的临时补丁。第三个揭示哪些指令实际上从未产生作用。第四个把保留下来的内容从「过程」改写成「结果」。
按顺序在任意助手、任意项目上运行它们。完成之后,你的助手所依据的指令就会指向同一个方向。
提示词 1:冲突查找器
从这里开始。它会找出彼此争夺控制权的指令,这是成本最高、也最不容易被发现的问题。
你只需要粘贴长期指令,就能得到一份按优先级排列的冲突清单。
纯文本
你是一名专门查找书面指令矛盾的编辑。

背景:下面的文字是我提供给 AI 助手的长期指令集合。我在一段时间内不断向其中添加内容,却从未删除过任何内容。

你的任务:找出每一对可能在同一个任务上把行动拉向不同方向的指令。

请保持全面。先完整阅读整个集合,然后逐条将每条指令与其他指令进行对照,包括那些在文本中相距很远的指令。

对于每一处冲突:
- 引用两条指令。
- 描述一个它们会发生碰撞的具体场景。
- 判断我最可能希望哪一条指令优先。
然后列出那些属于重复、而不是冲突的指令对。

如果某条指令过于含糊、无法判断,请说明这一点,并解释不清楚之处。

输出:
1. 冲突,按最常触发的顺序排列。
2. 重复的指令对。
3. 最应该优先解决的一处冲突,并用一句话说明原因。

我的指令:
[粘贴到这里]
你会得到什么:通常是 3 到 6 个真正的冲突,其中大多数是在相隔数月的时间里写下的。
通过删除你并不想要的那条指令,先解决排名最靠前的冲突。再添加第三条规则来调解争论,只会让文件变成现在这个样子。
提示词 2:过时性检查
它会把你真正想要的内容,与过去为了弥补某种缺陷而写下的内容区分开。
偏好应该保留。用于弥补已经不存在的限制的临时补丁,才是你会删除的大头。
注意,这个提示词会让模型去识别临时补丁,而不是让模型声称自己具备某种专业知识。告诉模型要寻找什么,比告诉它应该成为什么更有效。
纯文本
你正在检查一组指令,寻找已经不再需要的规则。

背景:下面的指令是在一段时间内为一个 AI 助手写下的。其中一些表达的是真实偏好,另一些则是为了弥补模型过去经常出现的问题,例如长篇啰嗦、编造事实、忽略格式,或跳过推理步骤。这些补偿性规则往往在问题消失很久之后仍然留在那里。

你的任务:将每一条指令归类为「偏好」或「临时补丁」。

「偏好」描述的是我希望事情如何完成,即使面对一个完美模型,它仍然重要。

「临时补丁」是为了阻止某种具体失败而存在的。常见形式包括:要求模型逐步思考,要求模型不要编造内容,限制长度以阻止它啰嗦,要求它使用一种它现在本来就会使用的格式,或为了强调而重复某条指令。

针对每一条临时补丁,说明它原本是为了阻止什么失败。
请逐条处理,不要只做概括。

如果你无法判断某种失败是否仍会发生,请标记为「不确定」,并说明需要进行什么测试。

输出:包含以下列的表格:指令、类型、它曾经阻止的失败,以及你的建议(保留、测试删除或不确定)。

我的指令:
[粘贴到这里]
你会得到什么:一张分为「保留」和「测试」两类的表格。
一次只测试一条「测试」栏里的指令。删除一条后,正常使用助手几天;如果质量下降,就把它放回去。
提示词 3:显而易见性测试
它会让助手报告:你的哪些指令真的改变了它的行为。
大多数人都会惊讶于自己的指令集合中,有那么多内容只是描述了模型本来就会做的事。
你就是接收以下指令的 AI 助手。

背景:我想知道下面哪些指令改变了你的输出,哪些只是描述了你默认会做的事。

你的任务:据此,诚实地判断每一条指令。
将每条标记为:

- 改变行为,并说明有它和没有它时,你的输出会有什么不同。

- 没有影响,意思是你默认就会这样做。

- 不清楚。

即使某条指令听起来很重要,也请诚实地标记「没有影响」。诸如全面、准确、专业、有帮助等一般质量要求,通常属于这一类。

如果一条指令混合了两种内容,请将其拆开,分别判断每一部分。

输出:
1. 三份清单。
2. 一份只包含会改变行为的内容的精简指令集合。
3. 你会删掉原始内容的百分比。

我的指令:

[粘贴到这里]
你会得到什么:三份清单、一份精简版本,以及一个百分比。
把精简版本当作候选方案,而不是直接替换的版本。采用之前先阅读一遍,因为模型有时会把真正的约束误判成默认行为。
提示词 4:从规则到结果
这是审计之后的改写步骤。
它会把逐步执行的流程规则转换为对最终结果的描述。这正是 Anthropic 对自家提示词所做的改变。
你是一名技术文档编辑,专门把流程文档转换为结果规格说明。

背景:下面的规则逐步告诉 AI 助手应该如何完成某件事。当前模型只要理解目标,就能自行处理路径,因此我想直接描述结果。

你的任务:弄清楚这些规则试图产生什么结果,然后直接描述这个结果。

请将替代版本写成三部分:完成后的输出是什么样子、它必须包含什么,以及什么情况会使它变得错误。
保留每一条真实约束,包括涉及安全、权限、法律要求或事实准确性的约束。这些内容必须继续明确写出。

如果你无法弄清某条规则的用途,请将它单独列出并询问我。

输出:
1. 用来替代原有规则的结果描述。
2. 你删除了什么,以及为什么删除是安全的。
3. 任何用途不清楚的规则。

我的规则:
[粘贴到这里]
你会得到什么:一组更短的指令,描述的是目的地,而不是路线。
Anthropic 自己的改写,就是目前最清晰的例子。
他们原来的提示词列出了一些关于注释和文档的流程规则。替代版本告诉模型:写出的代码应该像周围的代码,匹配现有代码的注释密度、命名方式和惯用风格。
一句话就覆盖了原规则没有预料到的各种情况。
最常见的错误
错误 1:把「更少上下文」误解为「不要上下文」。
无关且相互冲突的上下文会造成伤害。相关上下文仍然能带来很大帮助。
修正方法:判断删减是否成功,要看输出是否变差,而不是看文件缩短了多少。
错误 2:只审计一次。
这个问题会持续积累,因为每一次恼人的表现都会催生一条新规则,却没有任何机制触发删除。
修正方法:把审计安排进日程。每季度一次,或者每当你依赖的模型进行重大更新时做一次。
错误 3:删掉具体说明,却保留含糊规则。
人们会删掉看起来琐碎的详细技术说明,却保留听起来很重要的泛泛指导。
顺序应该反过来。详细说明是模型无法独自推断出来的唯一部分。
修正方法:在手动删除之前先运行提示词 3 。
错误 4:每犯一次错就增加一条规则。
这正是制造问题的习惯。一次糟糕的输出,就变成一条永久的新规则。
修正方法:增加规则之前,先检查是否是现有指令导致了这种行为。相比缺少规则,规则之间的冲突会制造更多错误。
这套审计不适用的地方
有四种情况,你应该保持现状,不要动它们。
小型模型和本地模型。上面所有内容都以当前的前沿模型为前提。
较小的模型、较旧的模型,以及大多数运行在你自己机器上的模型,仍然需要脚手架。如果你要审计其中一个,应当在你实际使用的模型上测试删除结果,而不是相信实验室研究中的发现。
上周刚搭建的设置。审计解决的是长期积累问题,而新的设置还没有积累内容。此时审计,只是在反复质疑你仍然记得自己为何做出的决定。
安全、法律和权限约束。凡是规定助手不得做什么、什么事情需要审批,或它不能访问什么的内容,无论模型能力变得多强,都必须保持明确。这些不是脚手架。
你已经满意的输出。如果助手已经能产出你想要的结果,这套审计只是可选维护,而不是修复问题。等质量下降,或模型更新之后再运行即可。
从这里开始
十分钟,三步。
-
把提示词 1 复制到保存着待审计指令的那个助手里。
-
在提示词写着「粘贴到这里」的位置,放入你的长期指令:ChatGPT 自定义指令、 Claude 项目指令,或 CLAUDE.md 文件。
-
阅读它找出的冲突,然后删除排名最高的那处冲突中的一方。选择你并不想要的那条指令。
第一次运行就是这些。
从冲突开始是正确的选择,因为它是成本最高的问题,也是你仅仅阅读自己的文件无法看见的问题。
两条指令都是你写的。在写下它们的那一天,两条看起来都很合理。
真正造成麻烦的是它们之间的碰撞,而这个碰撞会表现为你已经习以为常的输出问题。所以它可以在那里存在一年,而你始终没有注意到。
完成这一步后,再沿着各层向外检查。下一层检查记忆,因为你从来没有审阅过它。
你的指令不是关于工作的一切知识记录,而是模型无法独自推断出的那一小组内容。
你已经有了审计框架和四个提示词。剩下唯一的变量,是你会在自己的设置上运行它们,还是继续为一个已经不存在的模型支付那些过时指令的成本。
保存这篇文章。下一次你所依赖的模型进行重大更新时,再运行一次审计。冗余会在那时重新出现。
随着相关指导发生变化,我会继续更新这套方法。
关注 @free_ai_guides,获取更新 ❤️
订阅我的免费 newsletter,每周获得一个 AI 超能力:http://aisuperpowers.substack.com