Chubby Skills:视频转文字后,怎么存进自己的知识库
小红书、抖音、B站等素材可以转成 Markdown,后续再搜索、核对出处。平台抓取有边界,转写也不等于内容授权。
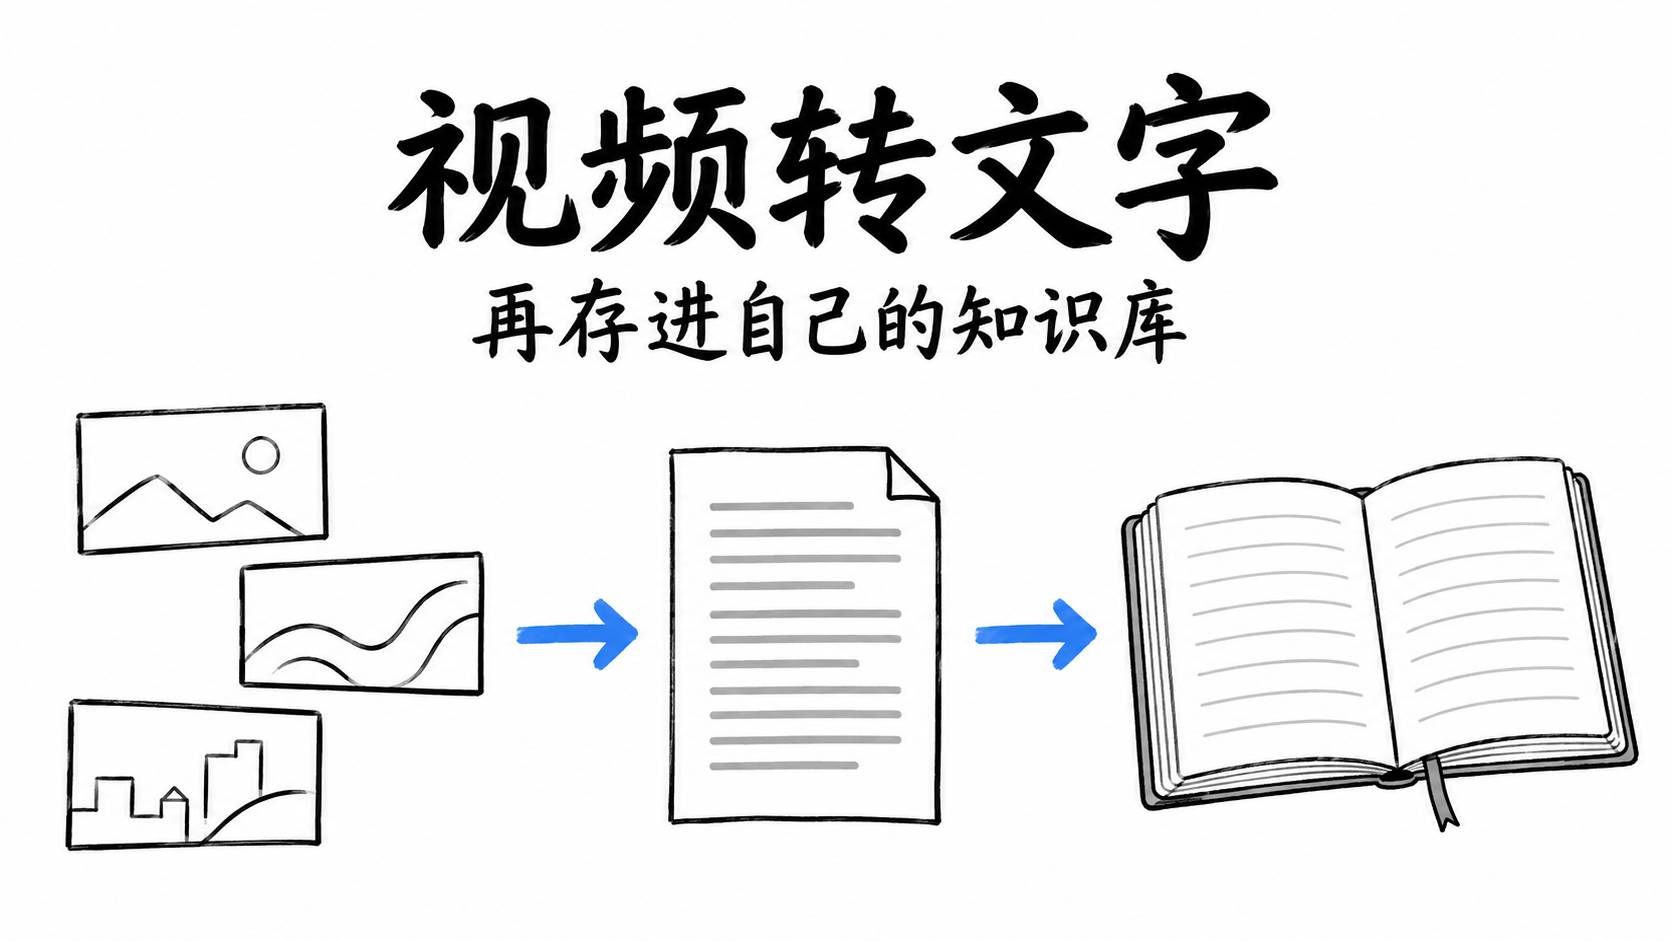
视频转成文字,只解决了“听懂”这一步。过几天要写文章、找一句出处,稿子还散在下载目录里,照样得重新翻。
Chubby Skills 想把这段接起来:采集视频或文章,保存为带来源信息的 Markdown,再放进本地资料库搜索。它不是一个只负责识别语音的转写器,也不是点一下就能稳定抓遍所有平台的万能下载器。
从视频到可回查的笔记
项目把 14 个 Agent Skill 和一组命令行工具放在同一个仓库里,覆盖视频、播客、文章和本地文档。视频字幕或转录结果可以写入 Markdown;知识库工具再负责导入、关键词检索和资料包导出。资料包会保留摘录、行号、来源和文件摘要,方便写稿前回去核对上下文。
举个实际的整理方式:看到一条有用的视频,先用对应平台的 Skill 采集字幕或转录,再把生成的 Markdown 导入自己的库。以后搜关键词,可以找回笔记和原始出处。需要把材料交给 Agent 时,还能导出 Markdown 或 JSON 资料包。这个过程把“收藏过”变成“找得到”,但观点是否准确,仍要自己回到来源里核实。
项目目前列出的平台包括抖音、 B 站、小红书、视频号等。不同平台的处理方式不一样:B 站优先抓字幕,拿不到字幕才需要下载音频并本地转写;抖音路径依赖视频解析和本地语音模型;小红书笔记可能是图文,也可能是视频,图文会保存图片,视频则尝试转成文字。
安装完还要看运行条件
把 Skill 放进 Codex 的技能目录,只是让 Agent 获得对应的操作说明。项目文档给出的安装方式是先取得完整仓库,再运行安装脚本,例如:
git clone https://github.com/chubbyguan/chubbyskills.git
cd chubbyskills
python3 tools/install_skill.py douyin-transcribe bilibili-transcribe xiaohongshu-ingest --dest ~/.codex/skills
安装器不会替你安装所有平台依赖。 B 站只走字幕路径时,依赖可以比较轻;没有字幕需要本地转写时,通常还要准备 ffmpeg 、 Python 音频包和语音模型。小红书采集可能受登录态和页面风控影响,仓库也提供手动文本回退。项目的在线平台状态会变化,页面上列出的“支持”不代表每条链接今天都能成功处理。
第一次使用,可以挑一条自己有权访问、长度不重要的公开视频做试验。拿到 Markdown 后检查转写错字、时间信息和来源链接,再决定是否入库。语音识别可能漏词或把专有名词听错,机器转出的文本不能直接当逐字准确的引文。
资料留在本地,不等于每一步都离线
普通文档导入、关键词搜索和资料包导出可以在本地完成。视频转写也可以走本地模型,但首次运行要下载模型,电脑需要留出存储空间和运行时间。
仓库还提供可选云转录和内容加工。选云端转录时,音频会发给对应服务商,可能产生费用;用外部模型做摘要、翻译或向量检索时,相关内容也会发送到配置的 API 。是否调用这些服务取决于所选路径和配置,不能把整套工具简单理解为“所有数据都只在本机”。
项目代码采用 MIT 许可,但这不代表抓下来的视频、图片和文章也可以随意转载。仓库把采集用途限定在个人学习与研究,并要求使用者遵守平台规则和内容版权。整理、搜索素材是一回事,公开引用或商业使用还得单独确认授权。
如果你常常存了视频却找不到重点,这类“转成笔记再入库”的流程值得试一条自己的素材。若只偶尔转一次字幕,单独的字幕工具更省事;遇到平台拦截,也别把绕过限制当成正常使用步骤。