
AI 工程师的四条路:岗位数据、能力重点与求职证据
AI 工程师不是单一岗位。用一份公开岗位数据拆开应用、平台、模型和前线交付四条路线,再给出零经验者能做的求职准备。
搜索“怎么成为 AI 工程师”,通常会得到一条很长的学习阶梯:Python 、数学、 Transformer 、微调,然后再补一堆框架。
这条路线的问题不在于知识点错了,而在于它把“AI 工程师”当成了一个岗位。
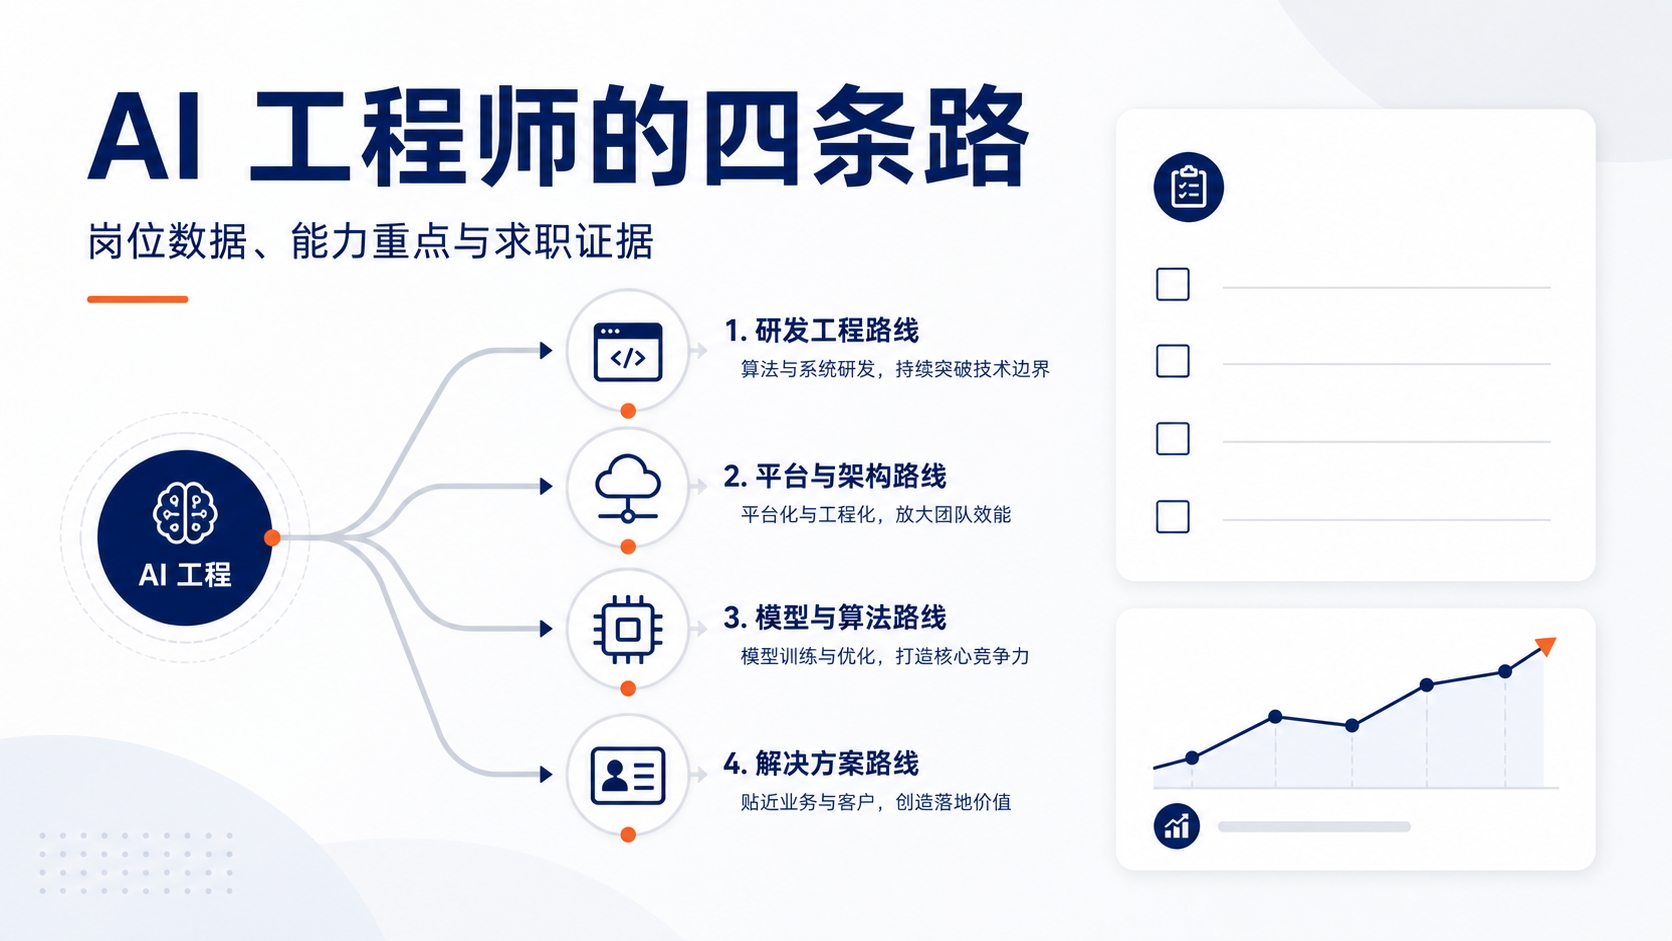
现实里的 AI 工程工作至少分成几种形态:有人把模型接进产品,有人负责模型网关和推理平台,有人做训练与微调,还有人直接进入客户业务,把演示版本改造成能运行的系统。岗位名称相似,日常工作却可能完全不同。
如果不先选方向,学习很容易变成收藏链接。下面用 AI Engineering Field Guide 这份公开资料库中的岗位数据,拆开四条路线,再说零经验者怎么做出能被检查的求职证据。
这份岗位数据能说明什么
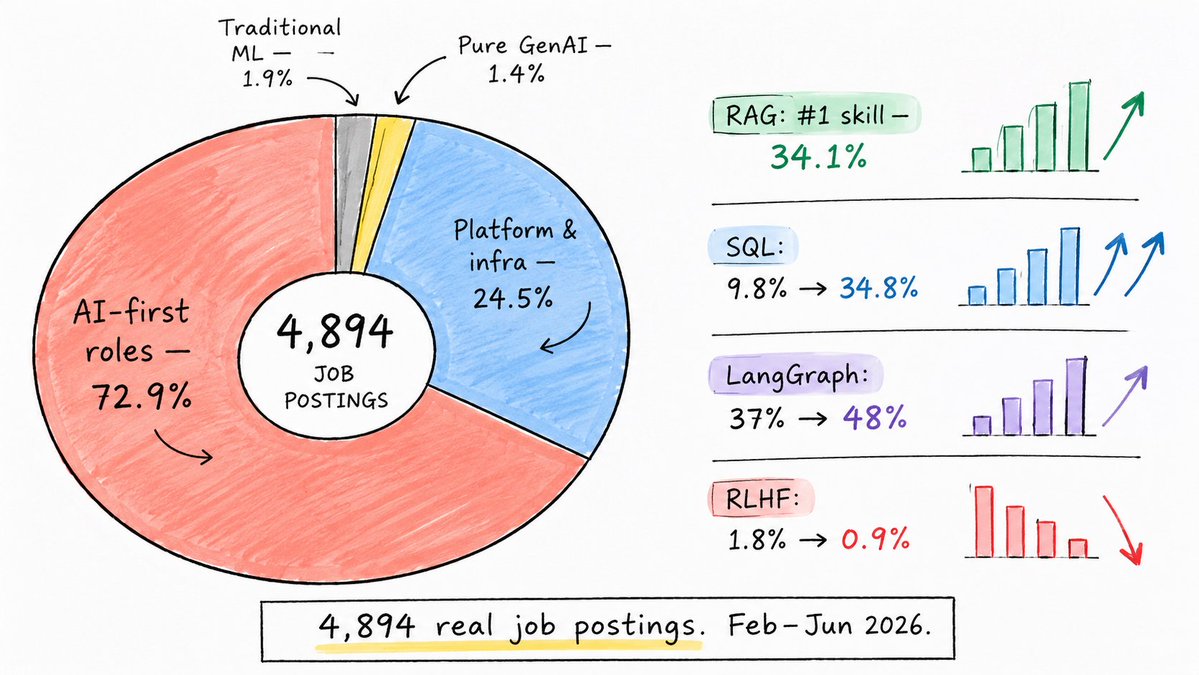
AI Engineering Field Guide 的 README 显示,仓库整理了 4,894 份来自 builtin.com 的岗位描述,覆盖洛杉矶、纽约、伦敦、阿姆斯特丹、柏林和印度。仓库还包含岗位分析、面试问题、学习路径、作品集建议和 FDE(Forward-Deployed Engineer,前线交付工程师)分析。
它不是招聘承诺,也不是完整的全球市场统计。岗位来源、抓取时间和分类方法都会影响结果。它的价值在于:比“我觉得未来应该学什么”更接近公司在招聘页面上实际写了什么。
仓库的趋势分析把岗位大致分为三类:直接做 AI 系统的岗位、为 AI 系统提供平台和基础设施的岗位,以及传统机器学习岗位。它还观察到,岗位描述越来越重视集成、部署、数据、评估和业务交付。
这意味着一个 AI 工程岗位通常不只是模型调用。 Python 、 SQL 、 HTTP 、数据库、云平台、 Docker 、日志和成本管理,都会和 RAG 、 Agent 、工具调用一起出现。
路线一:LLM 应用工程师
这条路线适合已经有后端、前端或全栈经验的人,也适合想快速做出第一个 AI 产品的人。
主要工作
LLM 应用工程师通常负责:
- 把模型 API 接进已有产品;
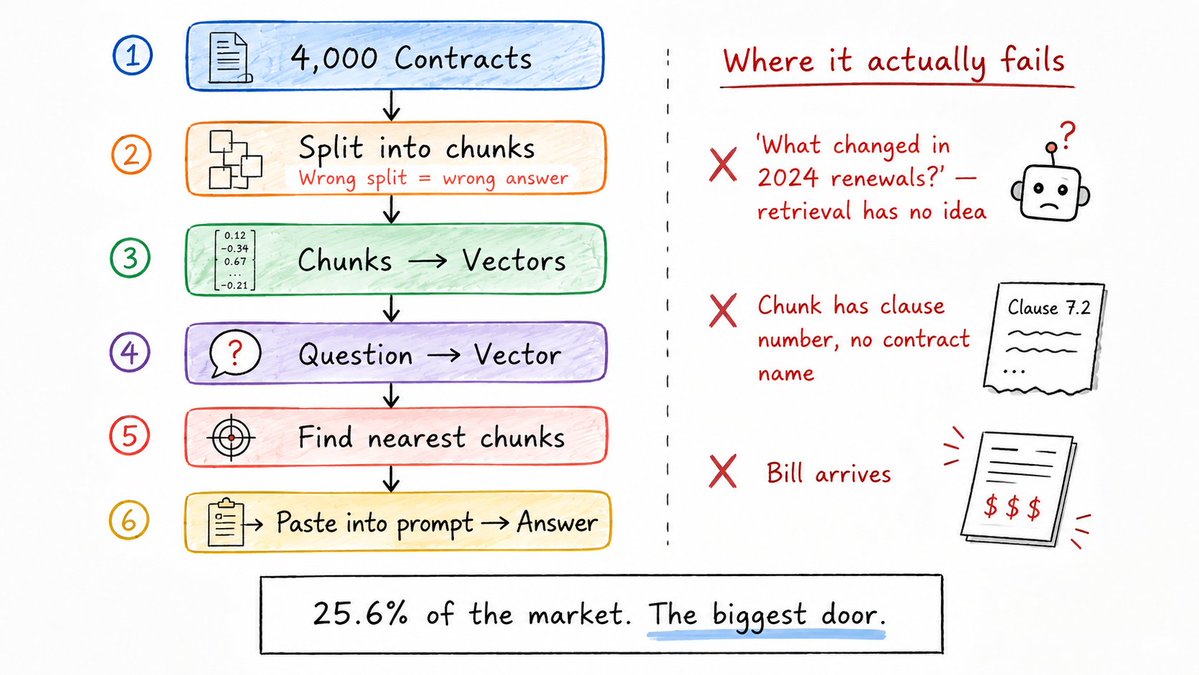
- 搭建文档问答和 RAG;
- 设计工具调用和结构化输出;
- 维护会话状态、流式响应和错误处理;
- 处理权限、数据来源和用户体验;
- 用评估集确认系统有没有变好。
一个合同问答系统看起来像“上传文档,然后提问”,但真正的工作会很快进入细节:文档怎么解析,章节如何切分,合同名称和日期放在哪些元数据里,检索结果是否包含完整条款,答案是否能给出引用,模型答不出来时怎么处理。
切分错误,检索可能拿到目录而不是条款。元数据不足,系统可能把不同年份的合同混在一起。没有评估集,团队只能凭感觉改 Prompt 。
适合什么人
如果你已经能写一个 Web 服务、处理数据库和 API,再补模型调用、 RAG 、评估和安全边界,通常比从头学习完整的模型训练栈更快形成作品。
起步项目不需要做成“万能 Agent”。一个能回答真实问题、展示引用、记录失败样本、说明成本和延迟的小系统,已经足够用来练习完整链路。
先学什么
- Python 、 HTTP 、 JSON 、 SQL 和异步基础;
- 一个模型 API 的调用、流式输出和结构化结果;
- 文档解析、切分、向量检索、过滤和重排;
- 评估集、错误分析、日志和成本统计;
- 用 FastAPI 等框架部署成一个可访问服务。
路线二:AI 平台工程师
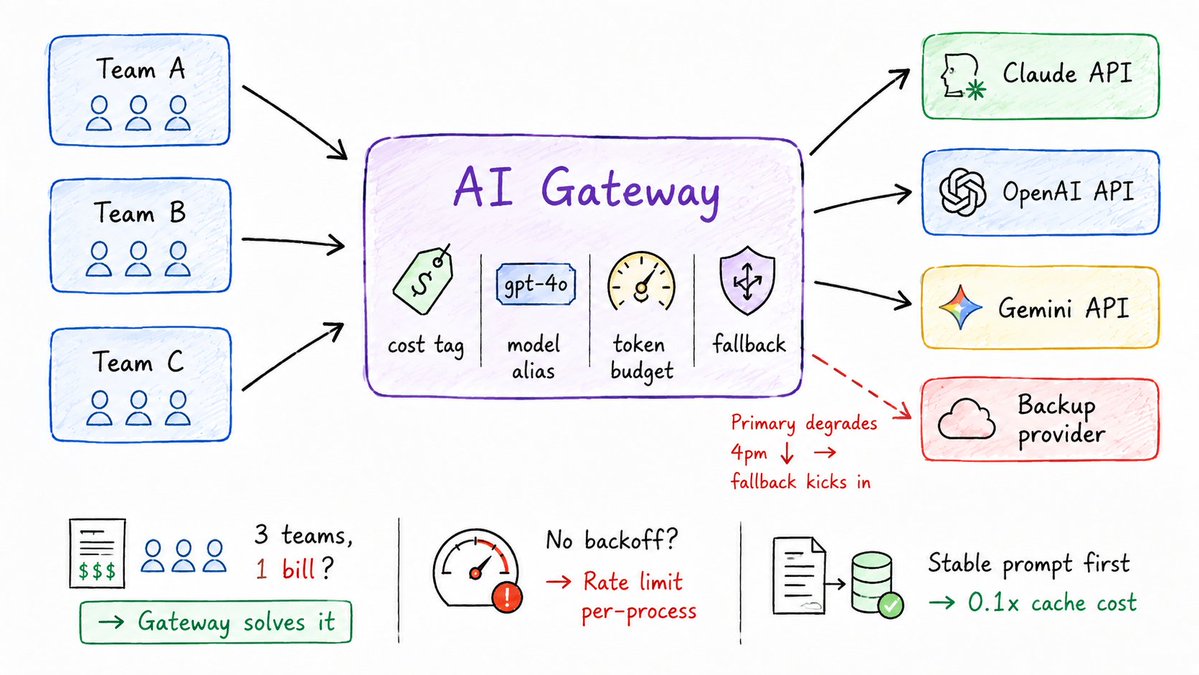
很多团队能做出 Demo,却没有统一的模型入口。不同部门各自保存 API Key,模型费用无法归属,某个服务变慢后也没有稳定的备用路线。
AI 平台工程师处理的就是这一层。
主要工作
- 模型网关和请求路由;
- 多模型、多供应商的统一接口;
- API Key 、团队和用户的费用归属;
- 配额、限流、缓存和故障转移;
- 模型别名、版本和输出格式;
- 日志、链路追踪、延迟和吞吐;
- Docker 、云平台、 CI/CD 和服务部署。
一个典型场景是:三支团队调用四家模型服务,每次调用都带上团队标识、模型别名和 Token 预算。主模型出现故障时,网关切换到备用模型,但不能悄悄改变输出格式。调用量增加后,缓存和限流要按全局服务工作,而不是每个进程各算各的。
这条路线更接近后端、平台和 DevOps 。它不等于“必须训练大模型”,也不等于“必须先学 CUDA”。如果你喜欢系统稳定性、费用、部署和故障处理,平台工程可能比追逐最新模型更合适。
路线三:ML / 模型工程师
这是最容易被课程宣传放大的方向,但从岗位数据看,传统训练和纯模型岗位通常只是市场中的一部分。
主要工作
- 数据清洗、标注和训练集维护;
- PyTorch 、 TensorFlow 等训练框架;
- 微调、实验管理和模型评估;
- 推理性能、显存和延迟优化;
- 模型训练流程和上线;
- 视觉、推荐、预测或其他机器学习任务。
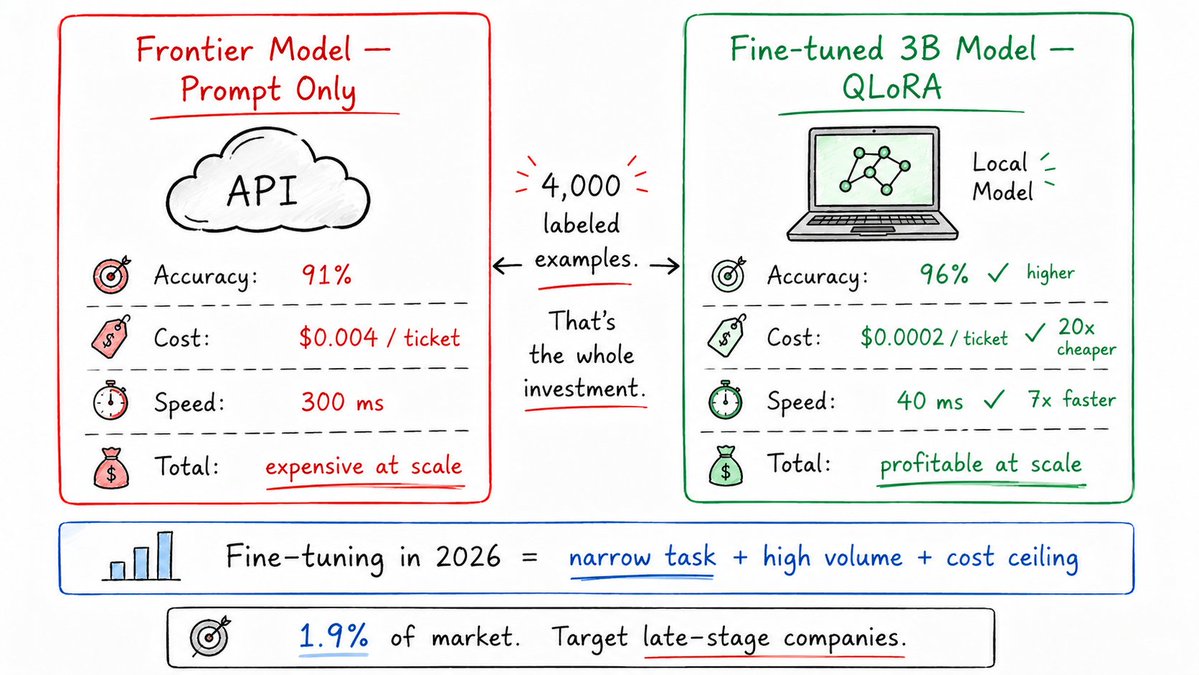
模型工程的工作也不只是“把模型训得更大”。一个客服分类任务可能需要判断:通用模型的效果是否已经够用,微调能否把成本或延迟降下来,训练数据是否足够稳定,业务标签改变后如何重新标注。
微调更适合窄任务、高调用量或有明确成本和延迟上限的场景。业务规则一变,训练集就会过时。很多项目后期最费时间的工作不是调参,而是定义标签、清洗数据和检查边界案例。
适合什么人
这条路线适合愿意长期补数学、机器学习、深度学习和系统工程的人。它对具体公司和岗位阶段依赖更强,准备时间通常也比做一个 LLM 应用更长。
如果你只是想做第一个 AI 项目,不必一开始就把目标设成预训练模型。先把一个应用问题做完整,再判断自己是否愿意继续向模型、训练和推理深入。
路线四:前线交付工程师
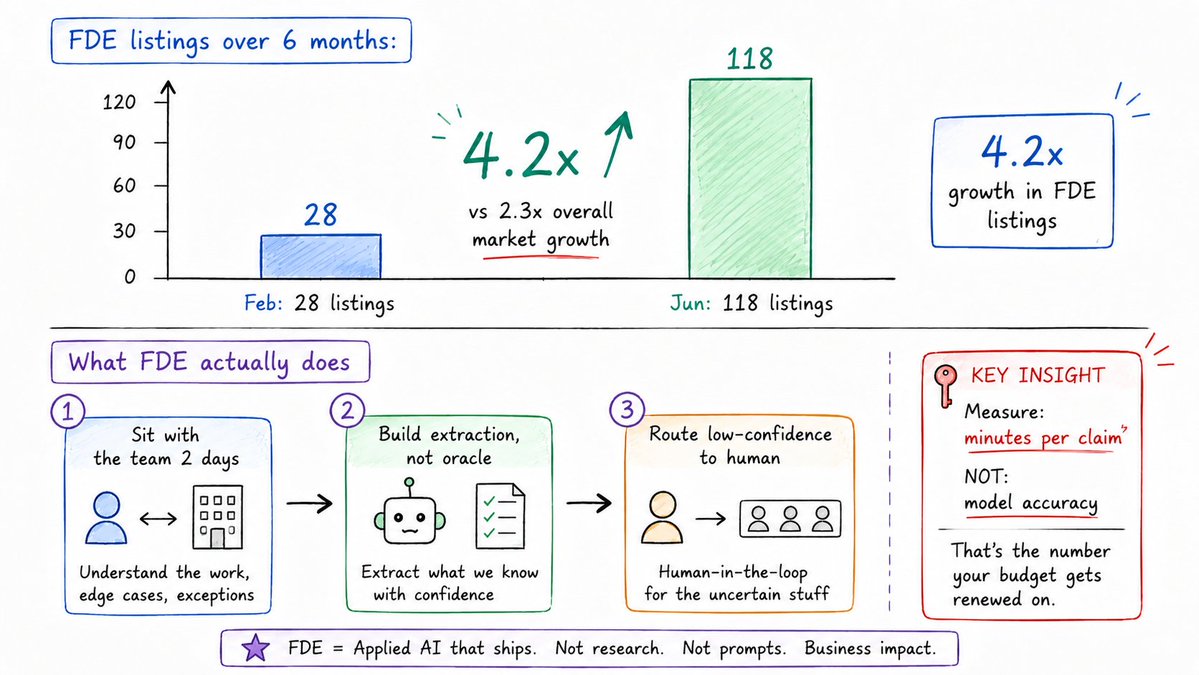
Forward-Deployed Engineer,常译为前线交付工程师。这个岗位把工程、业务理解和客户沟通放在一起。
它不是简单的售前演示,也不是把需求文档交给开发团队后就结束。工程师需要进入客户现场或业务流程,弄清楚实际工作怎么发生,再把系统接进去,并对落地结果负责。
一个典型场景
假设理赔团队每天处理大量单据。工程师先花时间观察他们的真实流程,因为内部 Wiki 写的步骤,往往和员工真正使用的步骤不一样。
系统可能能正确抽取 94% 的字段,但这不一定够用。如果每 16 份单据就有一份错误,而业务要求是每 500 份才允许出现一份问题,那么直接让模型替人决策就很危险。
更稳妥的设计是:
- 自动提取低风险字段;
- 把低置信度结果送进人工队列;
- 保存原始证据和修改记录;
- 先自动化信息整理,不直接自动化最终决策;
- 用每单节省多少时间,而不是单一准确率衡量效果。
这条路线需要 Python 、 RAG 、 Agent 、 API 集成和部署能力,也需要能和客户讨论问题。它适合愿意处理模糊需求、快速试错并把系统放进真实业务的人。
评估不是第五条路,是四条路的共同门槛
无论做应用、平台、模型还是前线交付,最后都要回答:系统到底有没有变好。
最小的评估流程可以从 30 个真实问题开始:
- 先写下什么答案才算合格;
- 跑一遍系统,人工阅读失败记录;
- 按原因给失败分类;
- 只改一个变量,再重新评分;
- 同时记录质量、成本和延迟。
失败分类可能包括:
- 没有检索到相关内容;
- 检索到了,但上下文不完整;
- 模型理解错问题;
- 工具调用失败;
- 输出格式不符合要求;
- 系统没有表达不确定性。
真正有用的评估,不是给项目配一个漂亮分数,而是让你知道下一步该改哪里。招聘方也更容易从错误样本里看出一个人有没有工程判断力。
零经验者怎么获得第一份信任
现在很多 AI 岗位并没有清楚写着“初级入口”。这不代表没有机会,但意味着求职材料需要更早证明:你能把一个系统做出来,也能发现它哪里不可靠。
先发布一次错误分析
选一个自己能运行的 RAG 或 Agent 系统,收集几十条真实记录,逐条标记错误原因。然后写清楚:
- 哪类错误最多;
- 你做了什么修改;
- 修改前后结果如何;
- 成本和延迟有没有变化;
- 哪些问题暂时没有解决。
这比在简历里罗列“熟悉 LangChain 、向量数据库、 Prompt Engineering”更有信息量。
再做一个完整但不大的项目
项目至少应该能回答这些问题:
- 输入从哪里来?
- 数据怎么处理?
- 模型如何调用?
- 结果如何验证?
- 失败如何记录?
- 成本和延迟如何观察?
- 用户如何知道答案依据?
合同问答、客服分类、内部文档搜索、业务表单抽取,都可以成为合适的练习题。重点不是功能数量,而是从输入一直走到可验证的输出。
最后再匹配岗位
- 已经有后端、前端或全栈经验,优先看 AI 应用工程;
- 喜欢云平台、网络、部署和成本,优先看 AI 平台工程;
- 有数学、机器学习或科研基础,再深入模型工程;
- 擅长沟通、理解流程和快速交付,可以关注前线交付。
方向选定后,学习内容会明显收敛。否则每个新框架都像必须补上的短板。
这份资料该怎么用
AI Engineering Field Guide 当前 README 中包含:
- AI 工程岗位和技能分析;
- 面试流程、题目和系统设计;
- 不同背景的学习路径;
- 作品集和项目选择建议;
- 岗位市场数据与趋势;
- 前线交付工程师分析;
- 按主题整理的学习资源。
仓库的 GitHub API 元数据没有显示根目录许可证文件,因此阅读和引用时,应该把它看成一份持续维护的资料库,而不是简单的“某许可证开源软件”。数据也只代表它抓取到的岗位样本,不代表所有公司和地区。
AI 工程的入门问题,最终不是“要不要学 AI”,而是你准备解决哪一种问题:把模型变成产品,把模型服务变成基础设施,把模型本身做得更好,还是把系统真正放进业务流程。
先选路,再补技能。比把四条路上的课程全部学一遍更省时间。