
OpenAI 把 Agent 运行时做成 API,开发者要重新理解什么?
Agents API 进入公开测试:OpenAI 提供 Codex 背后的编排能力和长时运行基础设施,开发者可以把精力放到工具、知识和业务流程上。
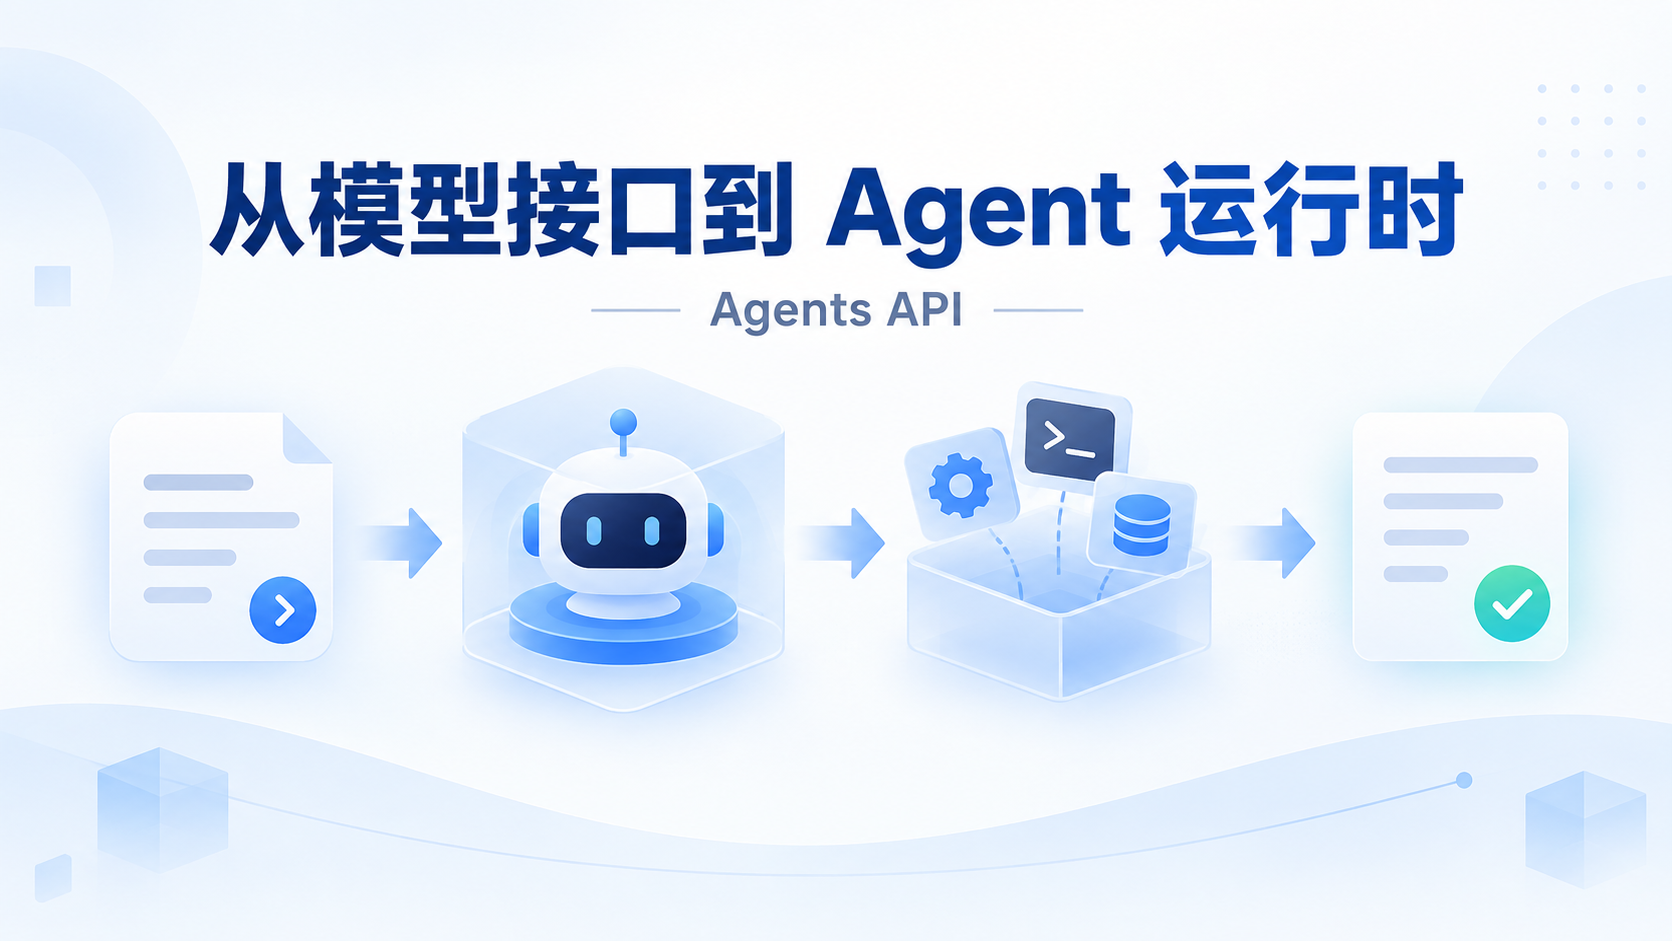
如果你做过 Agent,应该知道最费时间的部分往往不是把模型接上,而是让它连续工作:上下文不能乱,工具要会选,代码要在隔离环境里运行,中途还要能保存文件、处理失败、继续往下做。
OpenAI 这次推出的 Agents API,切入的正是这一层。它在公开测试阶段把 Codex 背后的 harness(编排层)和运行基础设施开放给开发者,目标是让一个 Agent 在云端跑上几个小时甚至几天,而不是只完成一次问答。
一次 API 调用,背后接管了哪些工作?
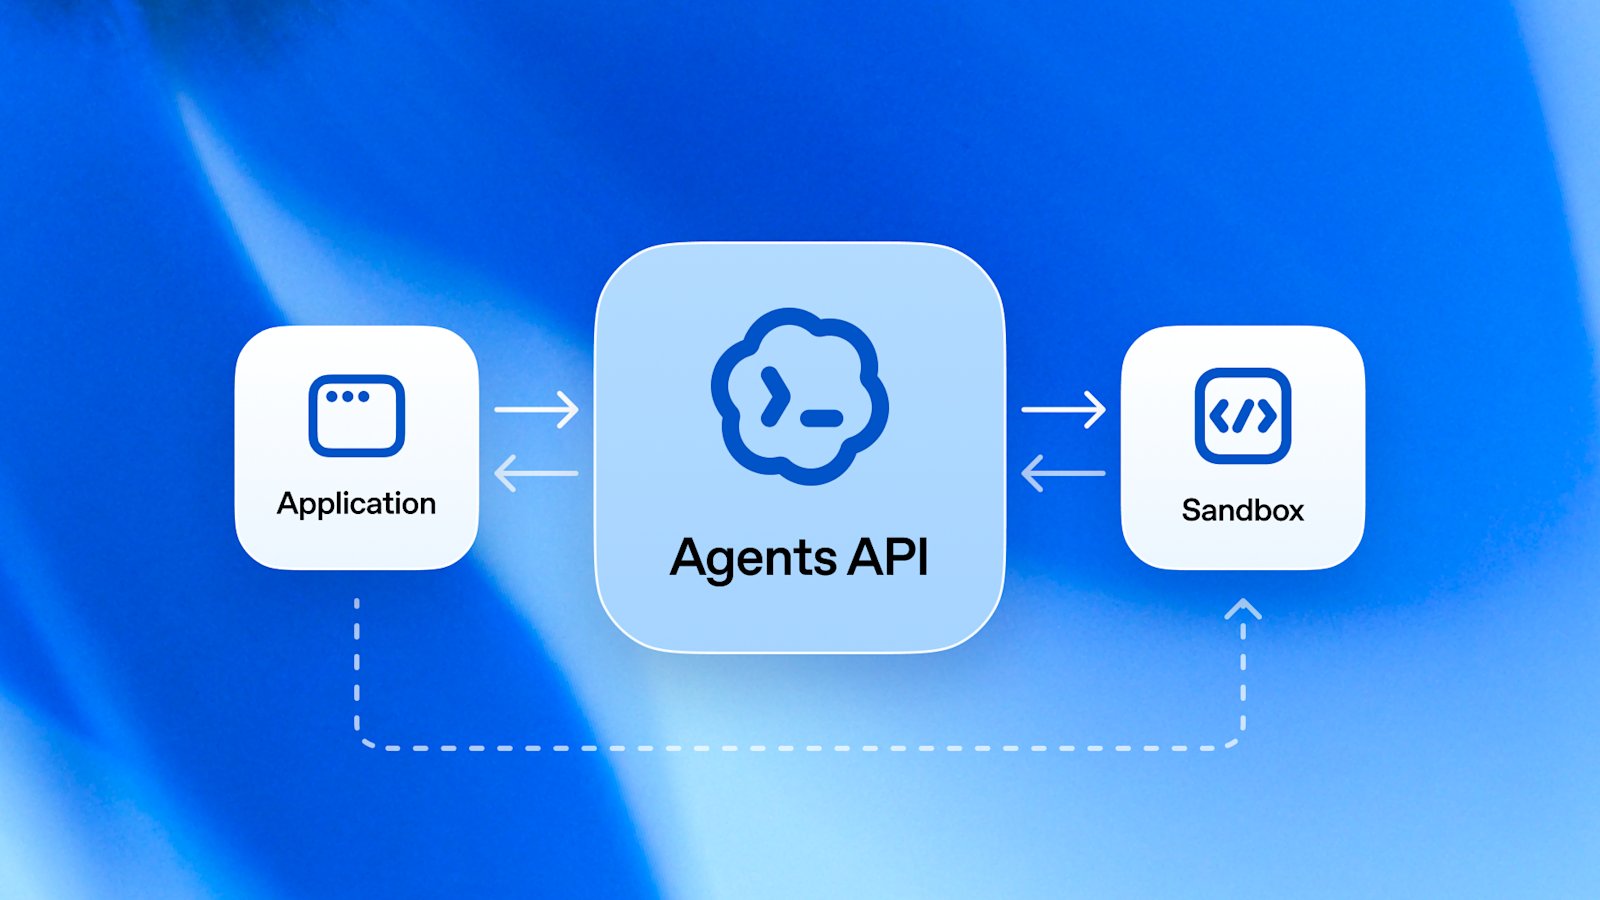
官方给出的使用方式很直接:开发者提交任务、模型、工具和运行环境,服务负责启动 Agent,并把过程中的事件和结果交还给应用。
这里的 harness,可以理解成 Agent 的“工作调度器”。它负责管理上下文、调用工具、安排子代理,以及让长任务在多轮上下文之间继续运行。应用本身仍然要负责产品界面、业务规则和结果审核。
这张图把关系画得比较清楚:应用提交任务,Agents API 负责调度,沙箱执行命令、读写文件,再把结果和事件返回应用。
开发者可以自己选运行环境
Agents API 并不要求所有任务都塞进同一个托管环境。公开资料列出了三种路径:
- 使用 OpenAI 管理的沙箱,快速开始;
- 使用自己的基础设施,例如企业自有网络或 VPC;
- 接入生态伙伴提供的沙箱环境。
合作方包括 Blaxel 、 Cloudflare 、 Daytona 、 DigitalOcean 、 E2B 、 Modal 、 Oracle 、 Runloop 和 Vercel 。不同环境的差别,不只是“能不能执行代码”,还包括文件和密钥怎么存、是否运行在自己的网络边界内、 CPU/GPU/内存怎么配,以及冷启动、成本和性能之间怎么取舍。
OpenAI 也提供托管沙箱。它可以配置文件、软件包、 skills 和 plugins,让 Agent 在隔离环境里运行代码、处理文件并产出文件结果。对个人开发者来说,这条路径更省基础设施工作;对企业来说,自有环境通常更容易满足数据和权限要求。
这套 API 具体补上了什么?
长上下文任务。 会话接近上下文上限时,系统会自动压缩较早的上下文,保留继续工作所需的信息。开发者不必从零实现一套上下文整理机制。
工具很多时的选择。 Tool search 会按需加载工具定义,避免每轮都把全部工具说明塞进上下文。工具真正可用后,programmatic tool calling 允许 Agent 在代码中并行调用、串联调用,并先过滤结果,再把有用的部分带回上下文。
复杂任务的拆分。 多 Agent 支持可以把研究、分析或编码任务拆开,让子代理并行处理。每个子代理有自己的上下文,主 Agent 负责协调和汇总。
这些能力以前通常需要开发者自己拼起来:状态管理、工具注册、重试、上下文压缩、并行任务和执行环境,一个都不能少。现在,至少有一部分被放进了模型服务旁边的运行时里。
对 Agent 框架意味着什么?
LangGraph 、 CrewAI 、 AutoGen 等框架仍然有用,尤其是在需要多模型、私有部署、复杂状态机或跨供应商迁移的场景里。但它们面对的竞争变了。
当模型厂商把上下文管理、工具调用和子代理协同随着模型一起更新,通用编排框架最容易被替代的部分,就是“把模型调用串起来”。框架要继续有价值,可能需要往更具体的地方走:跨模型中立、企业流程、权限治理、可观测性,或者某个行业的工具和数据连接。
这里不能简单得出“第三方框架没用了”。更准确的判断是:通用 Agent 编排会越来越像基础设施,差异化会向运行环境、数据、工具接入和交付流程移动。
对做 AI 产品的人,影响更直接
如果产品只是把“长时间运行、多 Agent 协作”当成卖点,竞争压力会变大,因为这类能力正在变成平台的基础配置。
以后更难被替代的部分,可能是:
- 业务数据怎么接入,哪些数据能用、不能用;
- 工具调用有没有权限边界和人工确认;
- 任务失败后如何重试、回滚和交接;
- 结果能不能进入真实业务流程,而不是停在一份演示报告里。
换句话说,Agent 的运行时可以购买或调用,但行业知识、数据责任和交付结果仍然要由产品团队承担。
“没有额外费用”不等于免费使用
Agents API 在公开测试阶段不收取额外的平台费用,但模型 token 和工具调用仍按官方定价计算。沙箱的计算、存储、网络和第三方服务,也可能产生独立费用。
这条边界很重要。一个任务能连续运行几天,不代表成本可以忽略;能在沙箱里执行代码,也不代表它适合直接接触生产数据库。上线前至少要把权限、密钥、网络访问、文件留存、人工审批和费用上限单独设计出来。
现在适合谁试?
如果你正在做需要长时间运行的研究、数据处理、代码维护或文件生成任务,Agents API 值得拿一个小任务验证:让它处理一批公开资料,生成中间文件,再根据检查结果继续修改。
如果你只是做一个简单问答机器人,暂时没有必要为了“Agent”三个字重做整套架构。普通模型调用加上明确的工具函数,可能更容易控制,也更容易算账。
目前它仍是公开测试版本,接口、价格和运行方式都可能调整。适合把它当成一条新的基础设施路线来观察和试用,不适合在没有权限隔离、成本控制和结果审核的情况下直接交给生产任务。
官方文档:https://developers.openai.com/api/docs/guides/agents-api/overview